O imposto do português: 9 tokenizers, 31 artigos, o mesmo conteúdo
Quanto o mesmo texto custa a mais em português do que em inglês, medido em 31 artigos deste site com nove tokenizers, e o que fazer com isso em prompts, orçamentos e RAG.
Compartilhe este post
Nesta página
- O problema e o contexto
- Mergulho na arquitetura
- Como um vocabulário ganha suas palavras
- A mesma palavra, contas diferentes
- Separando a tradução do tokenizer
- Implementação na prática
- A medição
- Os resultados
- O que isso significa em contexto e dinheiro
- Acentos: o atalho que sai pela culatra
- Conferindo o seu próprio texto
- Checagem de realidade em produção
- Estime na língua de destino, com o tokenizer de destino
- Compare modelos por palavra
- Dimensione chunks e janelas em tokens
- A língua do prompt é primeiro uma decisão de qualidade
- O que esta medição não cobre
Um time faz o orçamento de um assistente de suporte para um cliente brasileiro. Roda o protótipo em inglês por uma semana, lê a fatura, multiplica pelo tráfego esperado e põe uma margem. O lançamento em português vai bem até o fim do mês, quando a fatura chega um terço acima da estimativa, as conversas longas começam a bater no limite de contexto antes do que qualquer teste mostrou, e os chunks do RAG que guardavam uma seção inteira do manual em inglês agora cortam a seção no meio do caminho.
A conta estava certa, mas foi feita com tokens de inglês. Modelos não leem palavras nem caracteres, leem tokens, e a mesma ideia escrita em português ocupa mais tokens do que em inglês. Quantos a mais depende do modelo, e a diferença entre modelos é maior do que a maioria das pessoas imagina.
Eu queria um número para isso, medido em texto de verdade e não numa frase escolhida a dedo. Este site me dá um bom corpus: todo artigo existe em inglês e em português com o mesmo nome de arquivo, escrito para os mesmos leitores e com a mesma estrutura. Então tokenizei os 31 artigos publicados antes deste com nove tokenizers e comparei.
O problema e o contexto
Um tokenizer transforma texto numa lista de inteiros de um vocabulário fixo. Tudo o que custa dinheiro ou espaço num LLM é contado nesses inteiros: o preço por milhão de tokens de entrada e de saída, a janela de contexto, os limites de taxa, o KV cache na memória da GPU, o tempo para gerar a resposta. Uma frase que precisa de 30% mais tokens custa 30% mais, enche o contexto 30% mais rápido e leva 30% mais tempo para chegar inteira.
O inglês é a língua mais barata para quase todo tokenizer, por um motivo simples: os vocabulários foram aprendidos a partir de amostras dominadas por texto em inglês, então as palavras comuns em inglês viraram tokens únicos e o resto é montado em pedaços.

Os dois atalhos falham neste corpus. "Quatro caracteres por token" é uma regra de bolso para inglês num vocabulário da OpenAI. Nos artigos em português daqui, o número real vai de 4,23 caracteres por token (Llama 4) a 3,63 (Qwen3 e cl100k), então dividir por quatro erra 5% para cima num modelo e 9% para baixo em outro. E tirar os acentos, como vamos ver, deixa o texto um pouco mais caro nos tokenizers mais novos, além de deixá-lo errado.
Mergulho na arquitetura
Como um vocabulário ganha suas palavras
A maioria dos tokenizers atuais usa byte pair encoding (BPE). Antes de qualquer modelo ser treinado, o tokenizer é treinado numa amostra de texto: começa com bytes soltos e junta repetidamente o par vizinho mais frequente numa nova entrada do vocabulário, até chegar ao tamanho desejado, 100 mil ou 200 mil entradas, por exemplo. Na hora de usar, o texto primeiro é dividido por um pré-tokenizador (em espaços, pontuação e dígitos, com regras que mudam de modelo para modelo), e depois cada pedaço é codificado com as maiores entradas conhecidas.
A consequência é que o vocabulário é uma foto congelada da amostra de treino do tokenizer. Se o português era uma fatia pequena dessa amostra, poucas palavras e terminações em português foram frequentes o bastante para ganhar entrada própria, e a língua passa a ser soletrada em fragmentos. Dá para ver isso nos próprios vocabulários. Contei as entradas que contêm "ção" ou "ções", a terminação de palavras como informação e configurações:
| Tokenizer | Vocabulário | Entradas com "ção"/"ções" |
|---|---|---|
| GPT-4 cl100k | 100k | 20 |
| Llama 3 | 128k | 20 |
| Qwen3 | 151k | 39 |
| DeepSeek V3 | 129k | 40 |
| GLM-4.5 | 151k | 42 |
| Mistral Nemo | 131k | 60 |
| Gemma 3 | 262k | 151 |
| GPT-4o o200k | 200k | 219 |
| Llama 4 | 202k | 237 |
Vinte entradas querem dizer que a terminação existe, mas quase nenhuma palavra inteira que a usa. Duzentas querem dizer que boa parte do vocabulário comum do português técnico entrou como token único.
A mesma palavra, contas diferentes
Veja como quatro desses tokenizers dividem algumas palavras (com o espaço antes, como aparecem no meio de uma frase):
| Palavra | o200k | cl100k | Qwen3 | Gemma 3 |
|---|---|---|---|---|
| information | 1 | 1 | 1 | 1 |
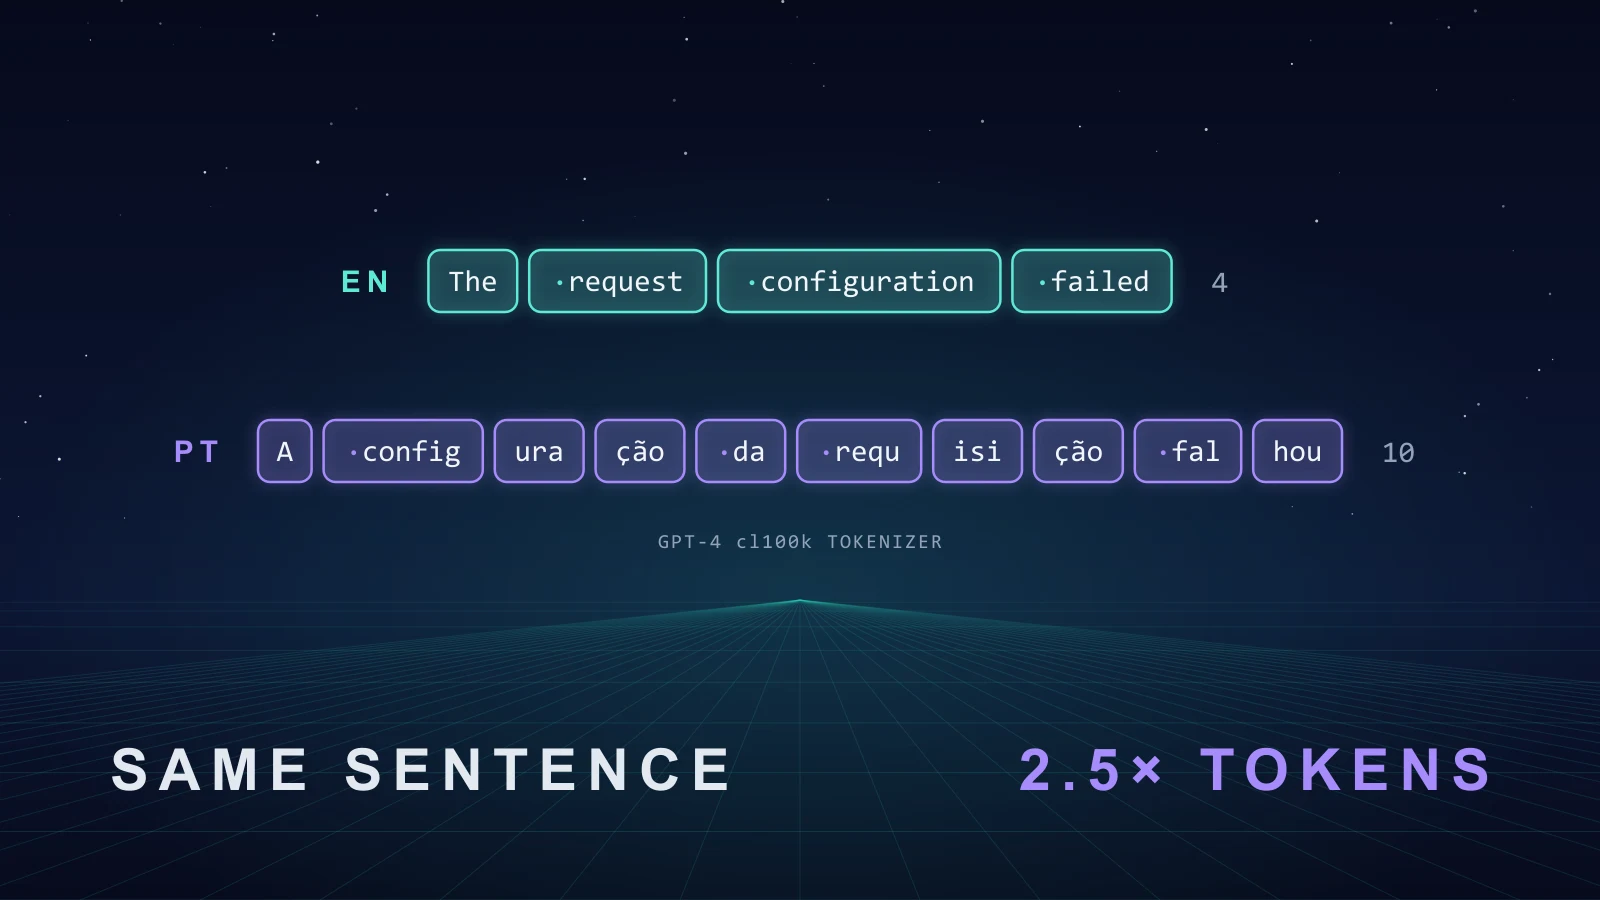
| informação | 1 | 2: inform + ação | 1 | 1 |
| implementação | 1 | 2: implement + ação | 2: implement + ação | 1 |
| configuração | 1 | 3: config + ura + ção | 3: config + ura + ção | 1 |
| requisição | 2: requ + isição | 3: requ + isi + ção | 3: requ + isi + ção | 2: requ + isição |
| informacao (sem acento) | 2: inform + acao | 2: inform + acao | 2: inform + acao | 2: inform + acao |
Dois detalhes importam para o que vem depois. Tokenizers em nível de byte, como o do Qwen, trabalham sobre os bytes do UTF-8, e "ç" e "ã" têm dois bytes cada, então um caractere acentuado que o vocabulário não conhece custa mais que um simples. E a versão sem acento é uma palavra que quase nunca aparece no texto de treino, então também não ganha entrada própria: informacao tem dois tokens em todos, enquanto informação tem um em três dos quatro.
Separando a tradução do tokenizer
Um texto em português costuma ser mais longo que o original em inglês, independentemente da tokenização: artigos, preposições e formas de palavra mais longas somam. Se eu digo "o português custa 35% mais tokens", parte disso é a língua e parte é o tokenizer, e só a segunda parte muda quando você troca de modelo.
O corpus permite medir as duas. Nos 31 artigos, depois de tirar código, HTML e links, as versões em inglês têm 88.097 palavras e 516.631 caracteres, e as em português, 94.998 palavras e 554.590 caracteres: 7,8% mais palavras e 7,3% mais caracteres. Um tokenizer que cobrasse exatamente o mesmo por caractere mostraria uma razão de 1,073. Tudo acima disso é o que o tokenizer acrescenta.
Implementação na prática
A medição
O script lê cada par de artigos, mantém só a prosa (frontmatter, blocos de código, código inline, HTML, links e tabelas ficam de fora, porque código é igual nas duas línguas e diluiria a comparação) e conta os tokens com cada tokenizer. Os vocabulários da OpenAI vêm do tiktoken; os outros são carregados do Hugging Face Hub com o tokenizers, que baixa só o tokenizer.json, sem os pesos.
import re
import unicodedata
from pathlib import Path

import tiktoken
from tokenizers import Tokenizer

POSTS = Path("src/content/posts")
HF = {
    "Llama 4 (202k)": "unsloth/Llama-4-Scout-17B-16E-Instruct",
    "Llama 3 (128k)": "unsloth/Llama-3.2-1B-Instruct",
    "Gemma 3 (262k)": "unsloth/gemma-3-4b-it",
    "Qwen3 (151k)": "Qwen/Qwen3-8B",
    "DeepSeek V3 (129k)": "deepseek-ai/DeepSeek-V3",
    "GLM-4.5 (151k)": "zai-org/GLM-4.5",
    "Mistral Nemo (131k)": "mistralai/Mistral-Nemo-Instruct-2407",
}
TIKTOKEN = {"GPT-4o o200k": "o200k_base", "GPT-4 cl100k": "cl100k_base"}


def prose(md: str) -> str:
    md = re.sub(r"\A---\n.*?\n---\n", "", md, flags=re.S)  # frontmatter
    md = re.sub(r"```.*?```", "", md, flags=re.S)         # blocos de código
    md = re.sub(r"<[^>]+>", " ", md)                      # HTML
    md = re.sub(r"`[^`]*`", " ", md)                      # código inline
    md = re.sub(r"\]\([^)]*\)", "]", md)                  # destinos de links
    md = re.sub(r"^\s*\|.*\|\s*$", "", md, flags=re.M)    # tabelas
    md = re.sub(r"[ \t]+", " ", md)                       # mantém as quebras de linha,
    return re.sub(r"\n{3,}", "\n\n", md).strip()          # como num prompt de verdade


def strip_accents(s: str) -> str:
    return "".join(c for c in unicodedata.normalize("NFKD", s) if not unicodedata.combining(c))


def encoders():
    for name, enc in TIKTOKEN.items():
        e = tiktoken.get_encoding(enc)
        yield name, lambda s, e=e: e.encode(s, disallowed_special=())
    for name, repo in HF.items():
        t = Tokenizer.from_pretrained(repo)
        yield name, lambda s, t=t: t.encode(s, add_special_tokens=False).ids


slugs = sorted(p.stem for p in (POSTS / "en-us").glob("*.md") if (POSTS / "pt-br" / p.name).exists())
en = [prose((POSTS / "en-us" / f"{s}.md").read_text(encoding="utf-8")) for s in slugs]
pt = [prose((POSTS / "pt-br" / f"{s}.md").read_text(encoding="utf-8")) for s in slugs]

for name, encode in encoders():
    en_n = sum(len(encode(t)) for t in en)
    pt_n = sum(len(encode(t)) for t in pt)
    plain = sum(len(encode(strip_accents(t))) for t in pt)
    print(f"{name:20} en={en_n:7,} pt={pt_n:7,} ratio={pt_n / en_n:.3f} no-accents={plain / pt_n - 1:+.1%}")
Duas escolhas ali são de propósito. O add_special_tokens=False deixa de fora o token de início de texto, que é igual nas duas línguas. E a comparação é feita por artigo e somada, então um artigo longo pesa mais que um curto, como pesaria numa fatura.
Também rodei o tokenizer do Phi-4. Os números bateram com o cl100k token a token em todos os artigos, porque o Phi-4 usa esse mesmo vocabulário, então ele ficou fora das tabelas.
Os resultados
Os 31 artigos, 31 pares, só prosa:
| Tokenizer | Tokens EN | Tokens PT | PT / EN | Faixa por artigo | Tokens PT por palavra |
|---|---|---|---|---|---|
| Gemma 3 (262k) | 117.396 | 137.824 | 1,174 | 1,12 a 1,22 | 1,45 |
| GPT-4o o200k | 111.490 | 131.662 | 1,181 | 1,14 a 1,22 | 1,39 |
| Llama 4 (202k) | 110.401 | 131.245 | 1,189 | 1,15 a 1,23 | 1,38 |
| Mistral Nemo (131k) | 116.946 | 144.121 | 1,232 | 1,18 a 1,28 | 1,52 |
| GLM-4.5 (151k) | 112.520 | 147.363 | 1,310 | 1,25 a 1,37 | 1,55 |
| DeepSeek V3 (129k) | 112.973 | 150.163 | 1,329 | 1,25 a 1,40 | 1,58 |
| Qwen3 (151k) | 114.098 | 152.671 | 1,338 | 1,27 a 1,39 | 1,61 |
| Llama 3 (128k) | 112.353 | 152.284 | 1,355 | 1,29 a 1,41 | 1,60 |
| GPT-4 cl100k | 112.361 | 152.546 | 1,358 | 1,30 a 1,41 | 1,61 |
Aparecem três grupos. Os vocabulários grandes mais novos (Gemma 3, o200k, Llama 4) cobram do português uns 18% a mais que do inglês. O Mistral Nemo fica sozinho no meio, com 23%. E os tokenizers dos laboratórios chineses caem junto com os ocidentais mais antigos, de 31% a 36%. Descontando os 7,3% que vêm de o português simplesmente ser mais longo, a parte do próprio tokenizer é de uns 10% no primeiro grupo e de 22% a 27% no último.
A coluna do inglês quase não se mexe: de 110.401 a 117.396 tokens, uma variação de 6%. A do português vai de 131.245 a 152.671, uma variação de 16%. Os nove lidam com o inglês mais ou menos igual; o que os separa é quanto português entrou nos seus vocabulários.
A linha do Llama é uma comparação bem controlada. O vocabulário do Llama 3 é o do cl100k, com 100 mil entradas, mais 28 mil adicionadas para outras línguas, e neste texto ele se comporta exatamente como o cl100k (1,355 contra 1,358), então essas entradas extras não chegaram ao português técnico. O vocabulário de 202k do Llama 4 derruba a razão para 1,189. Para quem acompanha as notícias: o novo Muse Spark Open, da Meta, lista um vocabulário de 202.048 entradas, o mesmo tamanho do Llama 4, então muito provavelmente herda esse comportamento (o repositório dele exige aprovação, então medi o tokenizer do Llama 4 no lugar).
O Gemma 3 tem a menor razão e mesmo assim não é o mais barato em números absolutos: o vocabulário de 262k cobre tantas línguas, provavelmente às custas do inglês, que o inglês dele precisa de mais tokens que os outros (1,33 por palavra). O português dele termina 5% acima do o200k. Por isso a razão sozinha não é o número para escolher modelo.
O que isso significa em contexto e dinheiro
Tokens por palavra viram quanto texto cabe numa janela. Com um contexto de 128k tokens:
| Tokenizer | Palavras em inglês em 128k | Palavras em português em 128k |
|---|---|---|
| Llama 4 | cerca de 102 mil | cerca de 93 mil |
| GPT-4o o200k | cerca de 101 mil | cerca de 92 mil |
| Qwen3 | cerca de 99 mil | cerca de 80 mil |
| GPT-4 cl100k | cerca de 100 mil | cerca de 80 mil |
Nos vocabulários mais antigos, uma conversa em português perde um quinto da janela em relação à mesma conversa em inglês. Em dinheiro a razão é a mesma: com o mesmo preço por token, um trabalho que custaria US$ 1.000 em inglês custa uns US$ 1.180 em português no o200k e uns US$ 1.340 no Qwen3.
Acentos: o atalho que sai pela culatra
A última coluna do script responde à segunda ideia do Júnior. O mesmo texto em português, com os acentos removidos por normalização Unicode:
| Tokenizer | Tokens com acento | Sem acento | Variação |
|---|---|---|---|
| Llama 4 | 131.245 | 134.615 | +2,6% |
| GPT-4o o200k | 131.662 | 134.480 | +2,1% |
| Gemma 3 | 137.824 | 140.541 | +2,0% |
| Mistral Nemo | 144.121 | 147.013 | +2,0% |
| DeepSeek V3 | 150.163 | 152.245 | +1,4% |
| Qwen3 | 152.671 | 153.505 | +0,5% |
| GLM-4.5 | 147.363 | 147.225 | -0,1% |
| GPT-4 cl100k | 152.546 | 151.888 | -0,4% |
| Llama 3 | 152.284 | 151.488 | -0,5% |
Nos tokenizers que aprenderam português, as palavras acentuadas são entradas inteiras e as versões sem acento não são, então tirar os acentos custa uns 2% a mais. Nos mais antigos, economiza meio por cento, no máximo. Nos dois casos você manda para o modelo um texto que nenhum falante nativo escreve, o que é uma entrada pior para um modelo treinado em português de verdade. Mantenha os acentos.
Conferindo o seu próprio texto
Para um prompt ou documento, as mesmas bibliotecas respondem em poucas linhas. Use o tokenizer do modelo que você vai chamar de fato: os números acima variam 16% no mesmo texto em português.
import tiktoken
from tokenizers import Tokenizer

text = open("system_prompt_pt.txt", encoding="utf-8").read()

o200k = tiktoken.get_encoding("o200k_base")
qwen = Tokenizer.from_pretrained("Qwen/Qwen3-8B")

print("o200k:", len(o200k.encode(text)))
print("qwen3:", len(qwen.encode(text, add_special_tokens=False).ids))
Para modelos cujo tokenizer não é público, como o Claude e o Gemini, os provedores oferecem um endpoint de contagem de tokens nas APIs; chame esse endpoint com uma amostra representativa em vez de chutar a partir de uma razão medida no tokenizer de outro modelo.
Checagem de realidade em produção
Estime na língua de destino, com o tokenizer de destino
Faça o orçamento de um produto em português com texto em português. Pegue algumas centenas de prompts e respostas reais (ou uma amostra traduzida, se o produto ainda não existe), conte com o tokenizer do próprio modelo e guarde essa razão ao lado do preço no seu modelo de custos. Uma métrica de custo por idioma em produção pega a surpresa da história do começo já na primeira semana, antes de a fatura chegar.
Compare modelos por palavra
Dois modelos com o mesmo preço por milhão de tokens não custam o mesmo para texto em português. Neste corpus, o Qwen3 precisa de 16% mais tokens que o o200k para o mesmo português, o DeepSeek V3 de 14% mais e o GLM-4.5 de 12% mais. Divida o preço de tabela pelos tokens por palavra da língua que você atende e o ranking pode mudar. Para o inglês a correção é pequena; para o português, não.
Dimensione chunks e janelas em tokens
O tamanho dos chunks de RAG costuma ser definido em tokens, e um chunk de 512 tokens guarda cerca de 15% menos conteúdo em português do que em inglês no o200k, e cerca de 26% menos no cl100k. Se o chunking foi ajustado em documentos em inglês, meça de novo no corpus em português antes de assumir que um chunk ainda guarda uma seção inteira (chunking de documentos corporativos mostra como testar isso). O mesmo vale para orçamentos de histórico de conversa e resumos disparados por contagem de tokens.
A língua do prompt é primeiro uma decisão de qualidade
Escrever o system prompt em inglês economiza tokens, de 15% a 26% deles conforme o tokenizer, e para um prompt longo e estático o prompt caching já deixa esses tokens baratos depois da primeira chamada. A pergunta maior é se as respostas em português continuam boas quando as instruções estão em inglês, e só as suas próprias avaliações respondem isso.
O que esta medição não cobre
O corpus é português técnico, cheio de termos em inglês (deploy, cache, embedding) que tokenizam igual nas duas versões, então português do dia a dia provavelmente mostra uma diferença maior. As traduções são minhas, escritas para este site, e outro tradutor produziria um tamanho um pouco diferente. E isto é só sobre tokenizers: um tokenizer mais barato deixa o modelo mais barato por palavra em português e não diz nada sobre a qualidade das respostas.
A versão curta, para a fatura: neste site, a versão em português do mesmo conteúdo custa de 17% a 36% mais tokens, conforme o modelo que a lê. Escolha o modelo primeiro pela qualidade de que você precisa e depois confira de que lado dessa faixa o tokenizer dele fica.
Compartilhe este post
Conteúdos relacionados
- BlogVectorless RAG posto à prova: PageIndex vs RAG vetorial no FinanceBenchO PageIndex troca o banco vetorial por uma árvore do documento e um agente LLM que a navega. Comparei com dois pipelines de RAG vetorial no FinanceBench: respostas melhores, 40 vezes o custo.
- BlogQuantizando LLMs sem chute: quanto 4 bits custam de verdadeO que a quantização faz com os pesos, as ativações e o KV cache de um LLM, e como medir o que você perdeu antes de colocar em produção.
- BlogUm LLM-as-a-judge em que dá para confiar: calibre o avaliador antes de acreditar na notaMeça os vieses de posição, de tamanho e de autopreferência de um juiz LLM, e a concordância dele com humanos corrigida pelo acaso, antes que as notas decidam alguma coisa.
Comentários
Dúvidas, correções ou sua própria visão são todas bem-vindas. Entre com o GitHub para participar.