Governança
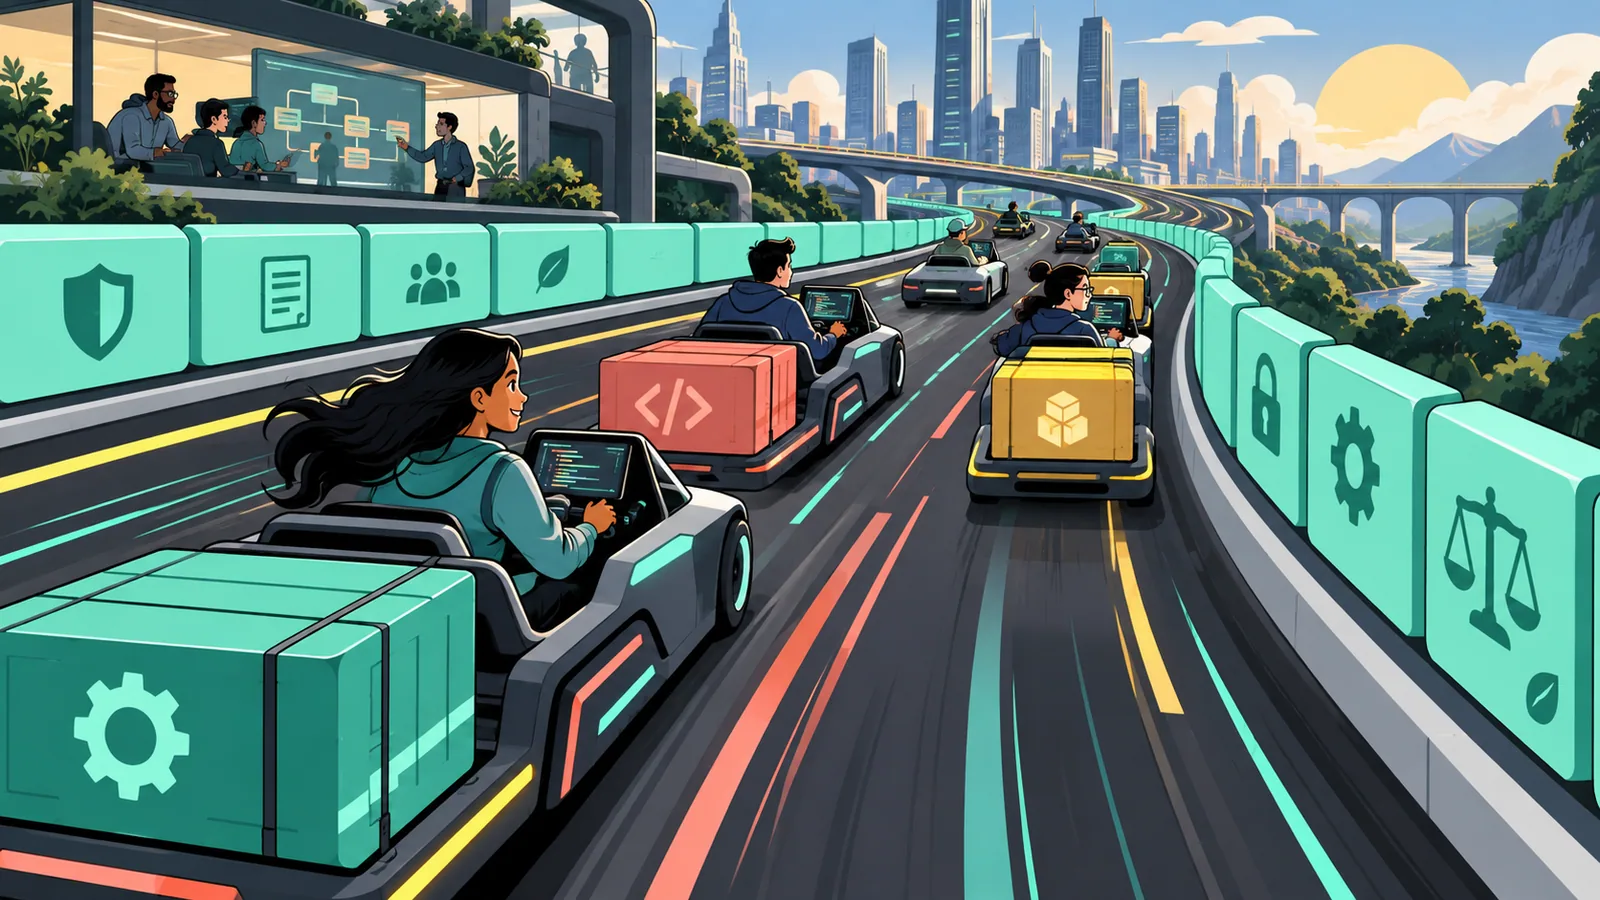
Guardrails, não portões: governança que deixa os times acelerarem sem cair do penhasco. Afinal, quem quer esperar um mês por uma reunião pra ouvir um sim?
35 min de leitura
Nesta página
- Introdução
- O comitê que se reunia uma vez por mês
- Guardrails, Não Portões
- Vias pavimentadas: faça do certo o caminho mais fácil
- Direitos de Decisão: Quem Decide o Quê
- RACI: deixando a responsabilidade explícita
- Revisão de arquitetura do jeito certo
- Architecture Decision Records (ADRs)
- Landing Zones e a Hierarquia
- Policy as Code
- Onde as policies rodam
- O ciclo de vida de uma policy
- Exceções Com Prazo de Validade
- Automação de Compliance e Evidência Contínua
- Medindo a Governança
- Princípios de Design para Governança
- 1. Codifique as regras, não apenas publique
- 2. Faça do caminho conforme o caminho mais fácil
- 3. Leve as decisões para onde está a informação
- 4. Registre as decisões por escrito
- 5. Trate exceções como cidadãs de primeira classe
- 6. Meça controle e fluxo
- Tradeoffs
- Controle vs autonomia
- Velocidade vs conformidade
- Tradeoffs com Excelência Operacional (Operational Excellence)
- Tradeoffs com Confiabilidade (Reliability)
- Tradeoffs com Segurança (Security)
- Tradeoffs com Otimização de Custos (Cost Optimization)
- Tradeoffs com Eficiência de Performance (Performance Efficiency)
- Conclusão
- Próximos Passos
Introdução
Fale a palavra "governança" numa sala cheia de engenheiros e repare nas caras. Alguém suspira, alguém olha pro teto e alguém abre discretamente uma aba nova pra atualizar o currículo. Pra muita gente, governança significa formulário, comitê, aprovação e aquela sensação de pedir licença pra fazer o próprio trabalho.
E sinceramente? Muitas vezes essas pessoas têm razão. Mas isso é governança mal feita, não governança em si.
A meta deste princípio é simples de dizer e difícil de fazer: garantir que as decisões importantes da organização sejam tomadas pelas pessoas certas, no nível certo, com as informações certas, e que as regras que saem dessas decisões sejam aplicadas automaticamente, sem transformar cada entrega numa gincana burocrática. Governança boa não atrasa os times. É ela que permite que uma empresa com cinquenta times ande rápido sem que cada um reinvente segurança, rede e compliance por conta própria (e erre em alguns deles).
Quando uma organização negligencia este princípio, ou implementa do jeito errado, os sintomas aparecem rapidinho:
- Cada time toma a mesma decisão crítica de um jeito diferente, e ninguém sabe qual é o "certo";
- Ninguém lembra por que aquele banco, aquela região ou aquele framework foi escolhido;
- A conformidade é verificada uma vez por ano, no desespero, na semana anterior à auditoria;
- Exceções concedidas "temporariamente" em 2019 continuam lá, firmes e fortes, em produção;
- Aprovações levam semanas, então os times aprendem a contornar o processo (o famoso shadow IT);
- As regras de segurança e custo vivem num PDF que ninguém abre desde que foi escrito;
Pois é, é raro, mas acontece bastante... Quem nunca viu?
O comitê que se reunia uma vez por mês
Deixa eu contar uma história que, com pequenas variações, eu já vi em mais de uma empresa.
Existia um Comitê de Arquitetura (o tal do ARB, Architecture Review Board). Ele se reunia na primeira terça-feira de cada mês. Pra entrar na pauta, o time precisava enviar um documento de design com duas semanas de antecedência, seguindo um template de trinta páginas. O comitê era formado por sete pessoas seniores, todas muito ocupadas, que liam os documentos (quando liam) na noite anterior.
Um time queria usar uma fila de mensagens gerenciada. Enviou o pedido. A reunião acabou antes de chegar no item deles. Próximo mês. Na segunda tentativa, o comitê pediu "um comparativo com três alternativas". Próximo mês. Na terceira, a decisão foi aprovada com a condição de "revisar a topologia de rede com o time de infraestrutura", que tinha o seu próprio comitê. Total: quase quatro meses pra usar um serviço que o provedor de nuvem oferece em dois cliques.
O que aconteceu depois é o que sempre acontece: o time seguinte nem pediu. Criou a fila numa assinatura pessoal, no cartão de crédito, "só pra testar". O teste foi pra produção. Ninguém sabia que aquilo existia até a fatura chegar, junto com um apontamento de auditoria sobre dados fora da região aprovada.
Um processo de governança lento demais não gera mais controle. Gera menos controle, porque as pessoas começam a dar a volta nele. O comitê mais rígido do mundo não governa nada se as decisões estão sendo tomadas fora dele.

Calma aí, Júnior! Jogar a governança fora é o outro extremo, e termina tão mal quanto. Sem nenhuma regra compartilhada, você ganha quarenta jeitos de lidar com segredos, doze stacks de log, buckets públicos cheios de dados de clientes e ninguém capaz de responder a pergunta mais simples do auditor: "quem aprovou isso, e por quê?".
A resposta não é "mais controle" nem "menos controle". É controle mais inteligente: tirar as regras da sala de reunião e colocar dentro da plataforma, e guardar o julgamento humano para as decisões que realmente precisam dele.
Guardrails, Não Portões
Essa é a ideia central da governança moderna, então vale explicar direitinho.
Um portão (gate) é um ponto de controle onde o trabalho para e espera a aprovação de alguém. É síncrono, manual e, por natureza, uma fila. Quanto mais times você tem, maior a fila.
Um guardrail é um limite embutido na estrada. Você dirige na velocidade que quiser, e o guardrail só se faz notar quando você está prestes a cair do penhasco. É automático, funciona o tempo todo e escala com o número de times sem ninguém precisar estar numa reunião.
Repare que o modelo de guardrails não elimina as regras. As regras são as mesmas (regiões permitidas, criptografia, nada de endpoint público pra dado interno, tags obrigatórias). O que muda é onde elas moram e quando são verificadas: em vez de uma pessoa lendo um documento uma vez por mês, uma policy avalia cada mudança, o tempo todo, em segundos.
Vias pavimentadas: faça do certo o caminho mais fácil
Guardrails dizem o que você não pode fazer. Uma via pavimentada (paved road, que algumas empresas chamam de golden path) mostra o que você deveria fazer, e transforma isso no caminho de menor resistência.
Na prática, a via pavimentada é um conjunto de blocos prontos pra usar, mantidos por um time de plataforma:
- Módulos de infraestrutura (Terraform, Bicep, Pulumi) que já vêm com criptografia, rede privada, diagnósticos e tags;
- Templates de serviço com pipeline, observabilidade e security scanning configurados de fábrica;
- Padrões pré-aprovados para os cenários mais comuns (API web, consumidor de eventos, job batch, site estático);
- Documentação explicando por que cada escolha foi feita.
O acordo com os times é claro: se você usa a via pavimentada, já está em conformidade. Sem revisão, sem ticket, sem espera. Se quiser sair da estrada, pode, mas aí o ônus de provar que a sua alternativa atende aos mesmos requisitos é seu.
Uma via pavimentada só funciona se for de fato melhor que a alternativa. Se o template oficial é mais lento, mais velho ou mais chato de usar do que fazer na mão, os times vão abandoná-lo, não importa quantas policies você escreva. Trate a plataforma como produto, com os times de desenvolvimento como clientes.
A via pavimentada tem interseção com padronização, e isso é intencional: os padrões reutilizáveis em si (quais linguagens, quais padrões, quais arquiteturas de referência) são assunto de Padronização. Aqui, o foco é a outra metade: quem decide o que entra na estrada e como as regras são aplicadas.
Direitos de Decisão: Quem Decide o Quê
Toda organização toma decisões de arquitetura o tempo todo. A questão é se ela sabe quem está tomando. Direitos de decisão pouco claros geram duas doenças opostas: tudo sobe pro comitê (paralisia) ou nada sobe (caos).
Um jeito útil de distribuir as decisões é olhar para duas dimensões:
- Raio de impacto (blast radius): quantos times, sistemas ou clientes são afetados se a decisão estiver errada?
- Reversibilidade: quanto custa desfazer? Trocar uma biblioteca é barato. Trocar o banco de dados principal ou o provedor de identidade da empresa, nem um pouco.
A Amazon popularizou essa ideia com a analogia das "portas de mão única" e "portas de mão dupla": decisões por onde dá pra voltar devem ser tomadas rápido, por quem está mais perto do problema. Só as portas de mão única merecem uma deliberação mais pesada.
A consequência prática: a maioria das decisões nunca deveria chegar a um comitê. Escolher biblioteca de JSON, nomear filas, organizar um repositório, escolher framework de teste: tudo isso mora no canto inferior direito. O fórum de arquitetura deveria ver um punhado de decisões por mês, não dezenas.
RACI: deixando a responsabilidade explícita
Para as atividades recorrentes de governança, uma matriz RACI elimina o problema do "achei que era você que ia fazer". Cada letra responde uma pergunta diferente: quem executa (R, Responsible), quem responde pelo resultado e dá a palavra final (A, Accountable, apenas uma pessoa ou papel por atividade), quem precisa ser ouvido antes (C, Consulted) e quem precisa ser informado depois (I, Informed).
| Atividade | Time de produto | Time de plataforma | Fórum de arquitetura | Segurança | CISO / CTO |
|---|---|---|---|---|---|
| Escolher bibliotecas e frameworks dentro da via pavimentada | R, A | I | |||
| Escrever um ADR para uma decisão entre times | R | C | A | C | I |
| Criar ou alterar uma policy corporativa | C | R | C | A | I |
| Conceder uma exceção a uma policy | R (solicita) | C | C | A | I |
| Manter landing zones e módulos da via pavimentada | C | R, A | C | C | |
| Definir os próprios princípios de governança | C | C | R | C | A |
O erro mais comum em RACI é ter mais de um "A" por linha. Se duas pessoas são responsáveis pelo resultado, ninguém é. O segundo erro mais comum é consultar todo mundo sobre tudo: cada "C" é alguém por quem o trabalho vai ter que esperar.
Revisão de arquitetura do jeito certo
Então é pra acabar com o comitê? Não necessariamente. Ele precisa mudar de natureza: de um portão que aprova projetos para um fórum que ajuda as pessoas a tomarem boas decisões e aprende com elas. Algumas características dos fóruns que funcionam:
- Assíncrono por padrão. A decisão é proposta por escrito (um ADR num pull request), as pessoas comentam ao longo de alguns dias, e a reunião só existe para os casos em que o texto não bastou.
- Conselho, não permissão. O Andrew Harmel-Law descreve isso muito bem no "processo de conselho" (advice process, veja as referências): qualquer pessoa pode tomar uma decisão de arquitetura, desde que antes busque o conselho de quem é afetado e de quem tem expertise. Quem decide continua responsável, e o fórum é o lugar pra pedir esse conselho.
- Prazo curto e previsível. Por exemplo, "se ninguém levantar uma objeção bloqueante em cinco dias úteis, a decisão está valendo". Previsibilidade importa mais do que velocidade.
- Só para portas de mão única. Todo o resto é decidido pelos times, dentro dos guardrails.
- Alimenta a plataforma. Quando o fórum vê a mesma pergunta três vezes, a resposta deveria virar um módulo da via pavimentada ou uma policy, pra ninguém precisar perguntar a quarta.
Porque daqui a dezoito meses, Júnior, metade desse "todo mundo" vai ter saído da empresa, e a outra metade vai lembrar da reunião de um jeito diferente. Aí alguém novo olha o sistema, pensa "que escolha estranha" e passa três semanas desfazendo uma decisão que tinha um ótimo motivo por trás. Ou pior, mantém uma decisão ruim por medo, porque ninguém sabe se ela foi deliberada.
Architecture Decision Records (ADRs)
Um ADR é um documento curto (uma ou duas páginas, no máximo) que registra uma única decisão significativa: o contexto, a decisão em si e as consequências. O formato foi popularizado pelo Michael Nygard, e a beleza dele está em ser pequeno. ADRs moram no repositório, junto do código, versionados no Git e revisados em pull requests como qualquer outra mudança.
Um template mínimo:
# ADR-0042: Usar fila de mensagens gerenciada para eventos de pedido

Status: Aceito (2026-09-10)
Decisores: Time de Pedidos, com conselho de Plataforma e Segurança

## Contexto
Eventos de pedido se perdem quando o consumidor reinicia. Precisamos
de entrega at-least-once e não queremos operar um broker.

## Decisão
Usar a fila gerenciada do provedor de nuvem, provisionada pelo módulo
da via pavimentada, com private endpoint e criptografia com CMK.

## Consequências
+ Nenhum broker para atualizar ou escalar.
+ Já em conformidade com as policies da landing zone.
- Dependência da API de fila do provedor (mitigada por um adapter).
- Os consumidores precisam ser idempotentes.
Alguns hábitos que tornam os ADRs úteis em vez de decorativos:
- ADRs são imutáveis. Quando uma decisão muda, você escreve um novo ADR que substitui o antigo, e o antigo continua lá com o status atualizado. O histórico é justamente o valor.
- Registre as alternativas descartadas, com uma linha explicando por quê. É exatamente isso que o leitor do futuro vai perguntar.
- Escreva na hora da decisão, não depois. Um ADR escrito seis meses depois é arqueologia, não governança.
- Ligue os ADRs às policies que nasceram deles. Quando uma policy bloquear alguém, a pessoa deveria achar o motivo em um clique.
Landing Zones e a Hierarquia
Os direitos de decisão dizem quem decide. A próxima pergunta é onde as decisões são aplicadas. Na nuvem, a resposta é a hierarquia de recursos: a estrutura de contas, assinaturas e projetos, e os agrupamentos acima deles.
Uma landing zone é um ambiente pré-configurado, pronto pra receber workloads, que já vem com identidade, rede, logs, segurança e as policies de governança no lugar. Em vez de cada time construir sua fundação do zero, eles "pousam" numa que já está em conformidade.
O pulo do gato é a hierarquia: as policies são atribuídas num nível alto e herdadas para baixo. Você escreve a regra "só estas regiões são permitidas" uma vez, lá em cima, e ela vale para todas as assinaturas ou contas abaixo, inclusive as que vão ser criadas no ano que vem.
- Na Azure, isso é feito com management groups, com atribuições de Azure Policy em cada nível;
- Na AWS, com o AWS Organizations e as organizational units (OUs), onde as Service Control Policies (SCPs) definem as permissões máximas permitidas em cada conta, e o AWS Control Tower empacota a landing zone;
- No Google Cloud, com a hierarquia de organização, pastas e projetos e as Organization Policies.
Algumas dicas de design para a hierarquia:
- Organize por necessidades de governança, não pelo organograma. Departamentos são reorganizados todo ano; a diferença entre "workloads privados" e "workloads expostos à internet" não muda. Se dois grupos têm as mesmas policies, provavelmente não precisam ser grupos separados.
- Mantenha rasa. Três ou quatro níveis costumam bastar. Hierarquias profundas dificultam entender qual policy vale onde.
- Tenha uma sandbox. Dê às pessoas um lugar pra experimentar com regras mais soltas e um limite rígido de orçamento. A alternativa são experimentos no cartão de crédito pessoal (lembra da história?).
- Tenha um grupo de descomissionados. Mover uma conta pra lá antes de excluir bloqueia tudo enquanto você confirma que ninguém ainda depende dela.
- Automatize a criação de contas (subscription vending ou account vending): um pedido num formulário ou num pull request gera uma conta nova, já no lugar certo da hierarquia, com rede e policies aplicadas. Esperar duas semanas por uma assinatura também é um portão.
Policy as Code
Já falamos de Policy as Code em Otimização de Custos, com foco nos guardrails de custo (limites de SKU, tags obrigatórias, orçamentos). Aqui a visão é mais ampla: policy como código é o mecanismo de aplicação de todas as decisões de governança, incluindo segurança, compliance, residência de dados e operação.
A ideia é tratar as regras exatamente como software: escritas numa linguagem declarativa, versionadas no Git, revisadas em pull requests, testadas automaticamente e publicadas por um pipeline. Chega de regra que só existe num PDF.
Onde as policies rodam
As policies podem agir em momentos diferentes, e um programa de governança maduro usa mais de um:
| Momento | O que faz | Exemplos de ferramentas |
|---|---|---|
| No pipeline do desenvolvedor (shift left) | Avalia o plano de IaC antes de qualquer coisa existir e quebra o build com uma mensagem clara. | OPA com Conftest, Checkov, tfsec / Trivy, Sentinel (Terraform) |
| No plano de controle da nuvem (preventivo) | Nega a chamada de API que criaria um recurso fora do padrão, não importa de onde ela venha. | Azure Policy (deny), AWS SCPs, GCP Organization Policies |
| Na API do Kubernetes (admission) | Rejeita manifestos que quebram as regras (containers privilegiados, imagens de registries não confiáveis). | OPA Gatekeeper, Kyverno |
| Depois do fato (detectivo) | Avalia continuamente o que já existe e sinaliza ou corrige o drift. | Azure Policy (audit, deployIfNotExists), regras do AWS Config, Security Hub, Defender for Cloud |
O pipeline dá feedback rápido; o plano de controle garante que ninguém dê a volta pelo portal ou pela CLI; a camada detectiva pega o que foi criado antes de a policy existir. Você quer as três.
Um pequeno exemplo, em Rego (a linguagem do OPA), avaliando um plano do Terraform no pipeline:
package terraform.storage

import rego.v1

deny contains msg if {
  some r in input.resource_changes
  r.type == "azurerm_storage_account"
  r.change.after.public_network_access_enabled == true
  msg := sprintf("%s: acesso de rede público não é permitido (veja o ADR-0017)", [r.address])
}
Repare na mensagem: ela diz o que está errado e aponta pra decisão por trás. Uma policy que só diz "negado" gera um ticket. Uma policy que se explica gera uma correção.
O ciclo de vida de uma policy
Uma policy nunca é ligada em modo deny no primeiro dia. Esse é o caminho mais rápido pra quebrar a produção e fazer a empresa inteira odiar governança. O caminho saudável é mais ou menos assim:
- Escrever: a policy é escrita como código, com um link para o ADR ou o requisito que a justifica, e revisada num pull request por plataforma, segurança e pelo menos um time de produto.
- Testar: testes unitários com exemplos conformes e não conformes, rodando no CI. Sim, policies também têm bugs.
- Modo auditoria: a policy é publicada só pra reportar. Por algumas semanas, você mede quantos recursos seriam bloqueados e conversa com os donos. É comum descobrir que a regra estava ampla demais.
- Aplicar: só então ela passa para deny (ou para correção automática, quando isso for seguro). Os times foram avisados, o caminho de migração está documentado e os módulos da via pavimentada já estão conformes.
- Evidência: o estado de conformidade é coletado continuamente e vira dashboard e relatório, o que fecha o ciclo.
Exceções Com Prazo de Validade
Por melhores que sejam as suas policies, vão existir casos legítimos que não se encaixam: um sistema legado que não dá pra migrar neste trimestre, um produto de fornecedor que exige endpoint público, uma prova de conceito com prazo apertado. Fingir que exceções não existem é o caminho pra acabar com aquela conta de admin "temporária" de 2019.
A resposta é um processo de exceção, tão formal e automatizado quanto as próprias policies:
- Solicitada por escrito, com a justificativa, o risco aceito e os controles compensatórios (por exemplo, "endpoint público, mas atrás de um WAF com allowlist de IPs");
- Aprovada pelo papel responsável, conforme o RACI (normalmente segurança, para policies de segurança, e não o gestor de quem pediu);
- Com o escopo mais restrito possível: um recurso, não a assinatura inteira;
- Com data de expiração obrigatória. As exemptions da Azure Policy têm o campo
expiresOn; com SCPs e OPA dá pra modelar o mesmo no código. Quando a data chega, a exceção some sozinha, e renovar exige uma nova justificativa; - Visível: todas as exceções ativas num só lugar, com donos e datas de expiração, revisadas periodicamente.
Seria mais fácil, Júnior, assim como é mais fácil arrancar o detector de fumaça porque ele apita quando você faz torrada. O problema é que "depois eu ligo de novo" é uma frase com taxa de conclusão baixíssima. E enquanto ela está desligada, está desligada pra todo mundo, não só pra você. Uma exceção com escopo restrito e prazo de validade te dá exatamente o que você precisa, pelo tempo que você precisa, e deixa um rastro explicando o porquê.
Acompanhe a lista de exceções como um sinal. Se a mesma policy acumula muitas exceções, o problema provavelmente é a policy (ampla demais, ou sem alternativa viável na via pavimentada), e não os times. Exceção é feedback, não só papelada.
Automação de Compliance e Evidência Contínua
Lembra do desespero na semana anterior à auditoria? Isso acontece porque a evidência é coletada de forma manual e periódica: prints de tela, planilhas exportadas, e-mails perguntando "você confirma que a criptografia está habilitada?". É lento, sujeito a erro e, pior de tudo, só prova que as coisas estavam certas no dia em que o print foi tirado.
A conformidade contínua inverte isso:
- Os controles são mapeados para policies. Cada requisito do framework que você segue (ISO 27001, SOC 2, PCI DSS, LGPD, normas internas) aponta para uma ou mais policies automatizadas. A Azure Policy e o AWS Security Hub já trazem iniciativas prontas mapeadas para vários desses frameworks;
- O estado é coletado o tempo todo. A camada detectiva avalia cada recurso continuamente, e o resultado fica guardado com data e hora;
- Evidência é uma consulta, não um projeto. Quando o auditor pergunta, você mostra o histórico de conformidade do período, as exceções com suas aprovações e os ADRs por trás das regras;
- As mudanças são rastreáveis. Como policies e infraestrutura estão no Git, "quem mudou essa regra, quando e por quê" é respondido pelo histórico de commits e pelo pull request.
Isso não elimina o auditor, e não cobre tudo (processos como revisão de acessos ou treinamentos ainda precisam de evidência humana). Mas transforma a auditoria de uma escavação arqueológica numa conversa baseada em dados. Para o lado de risco dessa conversa (apetite, registros, tratamento), veja Gestão de Riscos.
Medindo a Governança
Se você não mede a governança, não tem como saber se ela está ajudando ou só atrapalhando. E cuidado: medir só conformidade incentiva o comitê que bloqueia tudo (100% de conformidade, 0% de entrega). Você precisa de métricas dos dois lados, controle e fluxo.
| Métrica | O que ela mostra | Fique de olho |
|---|---|---|
| Taxa de conformidade (recursos conformes / recursos avaliados, por policy) | O quanto as regras estão sendo seguidas na prática. | Uma taxa alta com poucas policies pode significar que você está medindo as coisas erradas. |
| Tempo até a aprovação (do pedido à decisão, para ADRs, exceções, contas novas) | Se a governança é uma estrada ou uma fila. | A mediana esconde a cauda longa; olhe o percentil 90 também. |
| Adoção da via pavimentada (% de workloads usando os módulos e templates oficiais) | Se o caminho fácil é de fato o caminho fácil. | Adoção baixa é problema de produto do time de plataforma. |
| Exceções ativas e sua idade | Quanto risco foi aceito, e se ele está sendo pago. | Exceção renovada várias vezes é exceção permanente disfarçada. |
| Tempo para corrigir achados | Com que velocidade o drift é corrigido depois de detectado. | Separe por severidade; crítico e baixo não devem ter a mesma meta. |
| Decisões escaladas ao fórum por mês | Se os direitos de decisão estão bem distribuídos. | Muitas indicam falta de autonomia; zero pode significar que ninguém pergunta. |
Uma boa estrela-guia para a governança: tempo até produção conforme. Quanto tempo um time novo, partindo do zero, leva pra ter um serviço rodando em produção que já atende todas as policies? Em organizações com boas vias pavimentadas, isso se mede em horas ou dias. Na história do comitê mensal, se media em trimestres.
Princípios de Design para Governança
Juntando tudo, estas são as práticas que fazem da governança um acelerador em vez de um freio.
1. Codifique as regras, não apenas publique
Meta: toda regra de governança que pode ser verificada por uma máquina é verificada por uma máquina.
| Abordagem | Benefício |
|---|---|
| Escreva policies como código, versionadas e revisadas no Git. | As regras ficam testáveis, rastreáveis e auditáveis, com histórico de quem mudou o quê e por quê. |
| Aplique em mais de uma camada (pipeline, plano de controle, detectiva). | Feedback rápido para os devs, nada de dar a volta pelo portal e drift pego depois do fato. |
| Publique em modo auditoria antes do deny. | Você descobre o impacto real antes de quebrar alguém, e os times têm tempo de se adaptar. |
2. Faça do caminho conforme o caminho mais fácil
Meta: os times seguem as regras porque é o menor esforço, não porque têm medo.
| Abordagem | Benefício |
|---|---|
| Ofereça vias pavimentadas (módulos, templates, landing zones) conformes por padrão. | A maioria dos workloads nunca precisa de revisão, e a conformidade vem de graça. |
| Automatize o provisionamento de contas e ambientes. | Remove um dos portões escondidos mais comuns e a tentação de usar contas pessoais. |
| Trate a plataforma como produto, com feedback de quem usa. | As vias pavimentadas continuam atuais e realmente melhores que as alternativas. |
3. Leve as decisões para onde está a informação
Meta: as decisões são tomadas no nível mais baixo que tenha contexto e responsabilidade suficientes.
| Abordagem | Benefício |
|---|---|
| Classifique as decisões por raio de impacto e reversibilidade. | Só as portas de mão única recebem deliberação pesada; todo o resto é rápido. |
| Deixe os direitos de decisão explícitos com RACI, um "A" por atividade. | Acabou o "achei que era você que decidia isso". |
| Troque o comitê de aprovação por um fórum de conselho, assíncrono e com prazo. | Mantém a contribuição dos especialistas sem criar uma fila. |
4. Registre as decisões por escrito
Meta: a organização lembra por que fez o que fez.
| Abordagem | Benefício |
|---|---|
| Registre as decisões significativas como ADRs no repositório. | O contexto sobrevive à rotatividade do time, e quem chega entende o sistema mais rápido. |
| Ligue as policies aos ADRs que as motivaram. | Quem for bloqueado por uma regra encontra o motivo e pode contestá-la do jeito certo. |
| Substitua, não edite. | O histórico de decisões vira uma ferramenta de aprendizado. |
5. Trate exceções como cidadãs de primeira classe
Meta: desvios são permitidos, visíveis, limitados e temporários.
| Abordagem | Benefício |
|---|---|
| Exija justificativa, controles compensatórios e data de expiração. | O risco aceito é consciente e tem fim. |
| Mantenha as exceções em código, junto das policies. | Auditáveis e revisadas como qualquer outra mudança. |
| Revise periodicamente as tendências de exceções. | Exceções recorrentes revelam policies que precisam mudar. |
6. Meça controle e fluxo
Meta: a governança é julgada pelo que ela protege e pelo que ela viabiliza.
| Abordagem | Benefício |
|---|---|
| Acompanhe a taxa de conformidade e o tempo até a aprovação juntos. | Evita otimizar um às custas do outro. |
| Colete evidência continuamente. | Auditorias viram rotina, e os problemas aparecem em dias, não na próxima revisão anual. |
| Revisite as policies que ninguém disparou em um ano. | Mantém o conjunto de regras enxuto; regra morta é ruído. |
Tradeoffs
A governança é, no fundo, um equilíbrio entre duas coisas que a organização quer ao mesmo tempo: controle (consistência, segurança, conformidade) e autonomia (velocidade, inovação, senso de dono). Não existe uma configuração que maximize as duas. Cada regra que você adiciona compra um pouco de controle com um pouco de autonomia, e o trabalho do arquiteto é fazer essa troca de propósito.
Controle vs autonomia
Controle demais e você ganha o comitê mensal: os times param de propor, começam a contornar, e os melhores engenheiros vão embora pra lugares onde podem decidir as coisas. Autonomia demais e você ganha fragmentação: cada time com sua própria stack, nenhum aprendizado compartilhado, esforço duplicado e segurança inconsistente. O modelo de guardrails tenta pegar o melhor dos dois sendo rígido nos resultados (dados precisam ser criptografados, serviços internos não podem ser públicos) e flexível nos meios (use a linguagem ou o framework que quiser, dentro da estrada).
Velocidade vs conformidade
Toda checagem custa tempo, até as automáticas. Um pipeline com vinte scanners de policy que leva quarenta minutos também é um portão, só que robotizado. Mantenha as checagens rápidas, coloque as baratas primeiro e não bloqueie o build por achados de baixa severidade que podem ser acompanhados em vez disso.
Tradeoffs com Excelência Operacional (Operational Excellence)
Policies e landing zones são mais infraestrutura pra manter: código, testes, pipelines, versões, documentação. O time de plataforma vira uma dependência, e se ele estiver subdimensionado, a via pavimentada apodrece e vira gargalo. Por outro lado, governança bem feita reduz a variância operacional, que é exatamente o que a Excelência Operacional busca.
Tradeoffs com Confiabilidade (Reliability)
Uma policy de deny com bug pode bloquear deploys legítimos, inclusive correções de emergência durante um incidente. A correção automática pode alterar recursos em produção de jeitos que ninguém esperava. Mitigue com modo auditoria, rollout gradual das policies (um management group por vez) e um procedimento de break-glass documentado, rápido e, ele mesmo, auditado.
Tradeoffs com Segurança (Security)
A governança é uma das melhores aliadas da segurança, mas pode criar uma falsa sensação de proteção: "temos 100% de conformidade" só significa que você cumpre as regras que escreveu. Além disso, as permissões necessárias pra gerenciar policies e exceções são extremamente poderosas e precisam ser protegidas como qualquer outro acesso privilegiado. Para os controles em si, veja Segurança e Security Shift Left.
Tradeoffs com Otimização de Custos (Cost Optimization)
Landing zones vêm com componentes compartilhados (redes hub, firewalls, logs centralizados, ferramentas de segurança) que custam dinheiro antes mesmo do primeiro workload pousar. Conformidade contínua significa avaliação contínua e retenção de logs. Normalmente sai mais barato que um incidente ou uma auditoria reprovada, mas não é de graça, e organizações pequenas devem dimensionar a fundação para a sua realidade em vez de copiar um blueprint de grande empresa.
Tradeoffs com Eficiência de Performance (Performance Efficiency)
Algumas regras têm custo direto de performance: forçar o tráfego por um firewall central adiciona latência; restringir regiões pode deixar os dados longe dos usuários; criptografia obrigatória com chaves gerenciadas pelo cliente adiciona chamadas ao cofre de chaves. Muitas vezes são as escolhas certas, mas devem ser feitas de forma consciente, com os números na mesa.
Exatamente, Júnior, não existe quantidade perfeita, e ela muda conforme a empresa cresce. Olhe os sinais: se os times estão contornando o processo, se as aprovações levam semanas e a lista de exceções só cresce, você tem governança demais (ou do tipo errado). Se toda análise de incidente termina com "cada time fez de um jeito" e ninguém consegue responder o auditor, você tem de menos. As métricas da seção anterior existem justamente pra mostrar pra que lado você está pendendo, e os ADRs deixam você ajustar o rumo sem esquecer por que chegou até aqui.
Conclusão
Governança não é o comitê que diz não. É o conjunto de mecanismos que permite a uma organização tomar boas decisões de forma consistente, lembrar delas e aplicá-las automaticamente na escala de dezenas ou centenas de times. Quando funciona, a maioria das pessoas mal percebe: elas usam a via pavimentada, as policies as mantêm longe de encrenca em silêncio, e a rara decisão difícil recebe o conselho de especialistas em dias, não em meses.
A virada é de portões para guardrails: de pessoas lendo documentos uma vez por mês para policies avaliando cada mudança em segundos; de permissão para conselho; de decisões verbais para ADRs; de exceções permanentes para exceções com prazo de validade; de auditorias no desespero para evidência contínua.
E como todo princípio, a governança não elimina os tradeoffs. Controle e autonomia, velocidade e conformidade, sempre vão puxar para lados opostos. A boa governança deixa essa tensão explícita, mede e ajusta ao longo do tempo, alinhada ao que o negócio realmente precisa (veja Alinhamento com o Negócio).
Próximos Passos
-
Mapeie os direitos de decisão Liste as decisões de arquitetura recorrentes e classifique por raio de impacto e reversibilidade. Monte um RACI com um único papel responsável pelo resultado em cada atividade, e empurre para os times tudo o que der.
-
Comece a escrever ADRs Escolha um template, crie uma pasta nos repositórios e registre a próxima decisão significativa. Não tente documentar o passado de uma vez; comece agora e só resgate as decisões sobre as quais as pessoas vivem perguntando.
-
Codifique as cinco regras mais importantes Escolha as regras que mais importam (regiões permitidas, criptografia, nada de armazenamento de dados público, tags obrigatórias, logs) e transforme em policies. Publique em modo auditoria, meça, converse com os donos e só então aplique.
-
Construa a fundação Organize a hierarquia de management groups, OUs ou pastas por necessidades de governança, crie uma sandbox e automatize o provisionamento de contas com landing zones conformes por padrão.
-
Formalize as exceções Crie um processo leve e por escrito, com justificativa, controles compensatórios, aprovação pelo papel responsável e data de expiração obrigatória. Deixe a lista de exceções ativas visível.
-
Transforme o comitê de revisão Mude para conselho assíncrono e com prazo, só para portas de mão única, e faça com que ele alimente a via pavimentada, pra mesma pergunta nunca precisar ser feita duas vezes.
-
Meça controle e fluxo Acompanhe juntos a taxa de conformidade, o tempo até a aprovação, a adoção da via pavimentada e a idade das exceções, e revise regularmente com os times.
- Microsoft Cloud Adoption Framework: Govern
- Microsoft Cloud Adoption Framework: Azure landing zones
- Visão geral da Azure Policy
- AWS Organizations: Service control policies
- AWS Control Tower
- AWS Well-Architected Framework
- Open Policy Agent (OPA)
- OPA Gatekeeper
- Michael Nygard: Documenting Architecture Decisions
- Architecture Decision Records (adr.github.io)
- Andrew Harmel-Law: Scaling the Practice of Architecture, Conversationally
- The Open Group: TOGAF Standard
Conteúdos relacionados
- PrincípioPadronizaçãoPadrões e blocos reutilizáveis para que cada time pare de reinventar a roda. Afinal, quem quer corrigir o mesmo bug em doze loggers diferentes?
- PrincípioRacionalização do portfólioUm portfólio de aplicações enxuto, sem redundância e sem custo oculto. Afinal, pra que pagar três vezes pelo mesmo CRM?
- PrincípioAlinhamento com o negócioArquitetura que não mexe em nenhum indicador de negócio é só um hobby caro: toda capacidade, sistema e decisão precisa se ligar a um resultado que alguém realmente valoriza.
Comentários
Dúvidas, correções ou sua própria visão são todas bem-vindas. Entre com o GitHub para participar.