Mistral AI
Mistral apresenta o Large 4, um modelo de 1 trilhão de parâmetros que sai com pesos abertos este mês
O modelo de mixture-of-experts ativa 49B de parâmetros por token, lê texto e imagens e, pelos números da Mistral, lidera os modelos abertos da China em código com agentes. A API está em preview a US$ 1,36 e US$ 4,18 por milhão de tokens, quem trabalha com defesa cibernética recebe antes uma versão menos restrita, e os pesos saem em 27 de outubro.
Compartilhe esta notícia
Arthur Mensch, CEO da Mistral AI, apresentou o Mistral Large 4 na terça-feira, no AI Everything, em Abu Dhabi. O modelo tem 1 trilhão de parâmetros, dos quais 49 bilhões ficam ativos a cada token, aceita imagens além de texto e foi treinado em mais de 160 idiomas, incluindo todos os idiomas oficiais da União Europeia. A Mistral treinou o modelo do zero em 3.800 GPUs NVIDIA Grace Blackwell nos seus próprios data centers europeus.
Um preview público já está no Mistral Studio a US$ 1,36 por milhão de tokens de entrada e US$ 4,18 por milhão de tokens de saída. Os pesos saem no fim do mês, em 27 de outubro segundo a VentureBeat e o The Next Web. O post da Mistral não cita a licença, e a VentureBeat informa que os pesos virão com uma licença própria da Mistral, e não com uma licença open source padrão.
Onde ele fica
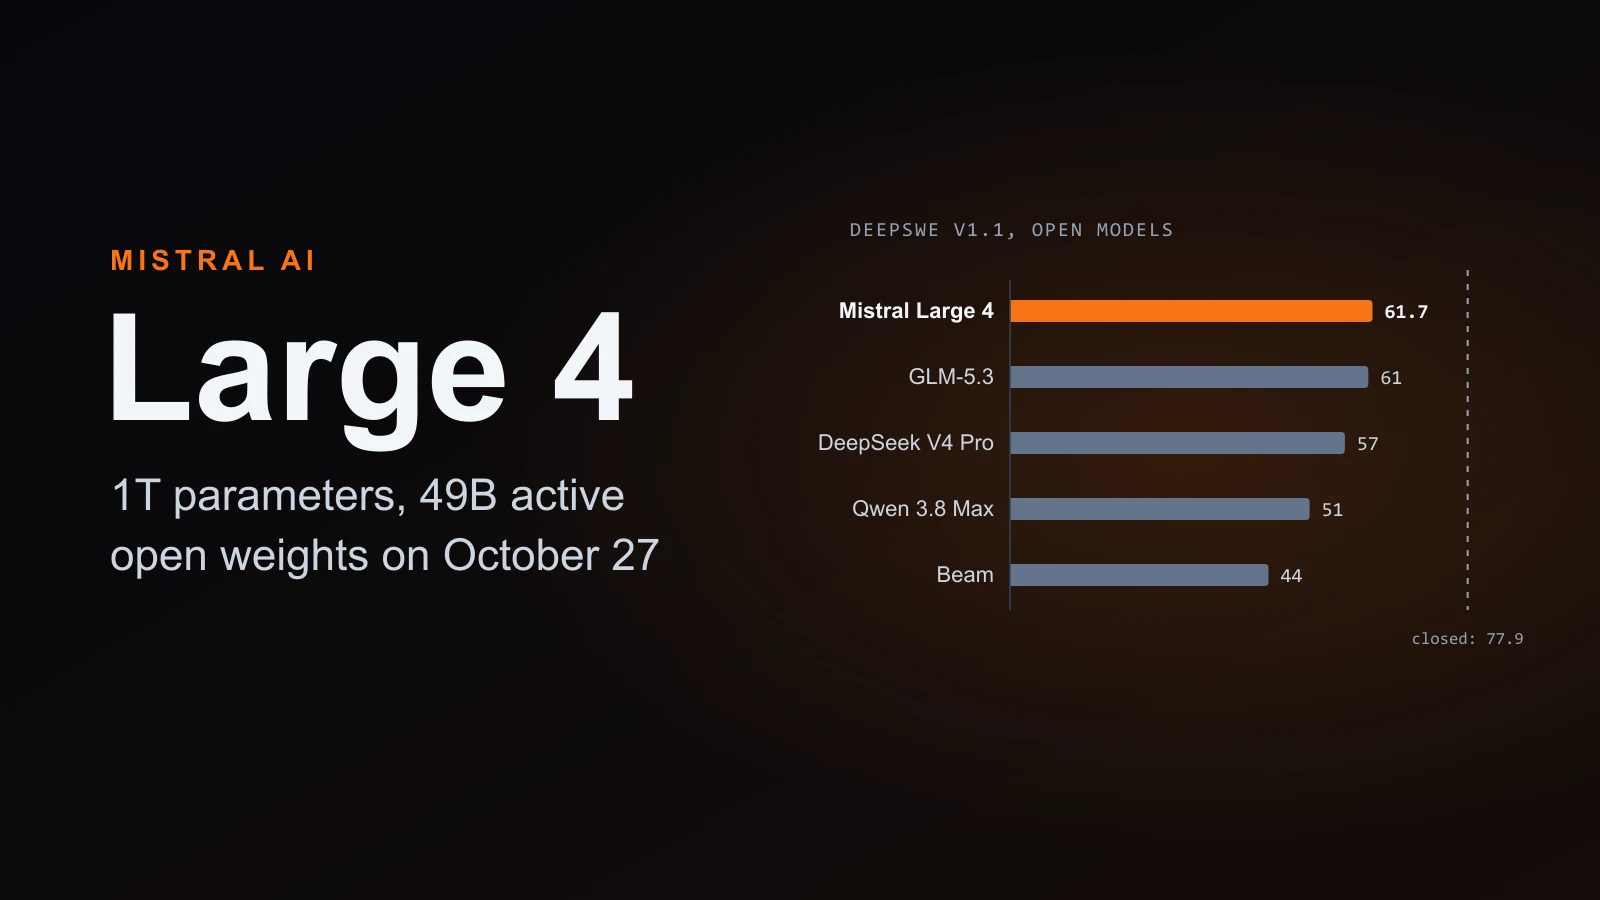
A Mistral informa 61,7% no DeepSWE v1.1, o benchmark de código com agentes. Na comparação publicada junto com o lançamento, isso põe o Large 4 à frente do GLM-5.3 da Zhipu, com 61%, do DeepSeek V4 Pro, com 57%, e do Qwen 3.8 Max, com 51%, e bem à frente do Beam da Reflection, anunciado na segunda-feira, com 44%. A fronteira fechada continua mais longe: o Google informou 77,9% para o Gemini 4 Argon na semana passada. Os outros números de destaque são 67% no FinWorkBench, empatado com o DeepSeek V4 Pro, 82% no AA Cyber Index para reprodução de vulnerabilidades, 93% no Cybench, 28,3% no Terminal Bench 4.0 e 42% em grounding visual no Dense200, um ponto acima do GPT-6 Astra pela conta da Mistral.
Primeiro, um modelo de segurança
O preview de três semanas vai primeiro para "líderes de cibersegurança, parceiros verificados e autoridades de Estado", que recebem uma versão com moderação reduzida e capacidades cibernéticas ampliadas em relação à API pública. A Mistral apresenta isso como defesa contra atacantes que fazem jailbreak em modelos fechados e junta um argumento de soberania voltado a empresas e governos europeus: eles recebem garantias contra restrições de acesso vindas de fora, porque, nas palavras da Mistral, não deveriam "depender de um fornecedor que pode desligar suas ferramentas a qualquer momento".
O que conferir quando os pesos saírem
Todos os números acima vêm de testes da própria Mistral e continuam provisórios até que equipes de fora testem os pesos liberados. Dois detalhes vão definir o quanto o lançamento é aberto de verdade. Um é o texto da licença, que a Mistral não publicou. O outro é o hardware: um trilhão de parâmetros ocupa cerca de um terabyte de memória mesmo em FP8, o que exige um servidor com oito das maiores GPUs da NVIDIA ou mais. Isso deixa a hospedagem própria ao alcance dos governos e das grandes empresas que a Mistral citou como primeiros clientes, muito mais do que de desenvolvedores individuais.
Fontes e leituras complementares
- Publicação original
- Mistral AI: apresentando o Mistral Large 4
- VentureBeat: Mistral estreia o Large 4 "Le Chonk", um modelo de 1 trilhão de parâmetros com pesos abertos previstos
- The Next Web: a europeia Mistral lança o Large 4 para disputar a liderança da China em modelos abertos
- SiliconANGLE: Mistral lança o Mistral Large 4 e detalha seu roadmap de IA
- AI News: Mistral AI lança o preview do Large 4 antes da liberação dos pesos
Compartilhe esta notícia
Conteúdos relacionados
- NotíciasReflection AI apresenta o Beam, um modelo de pesos abertos com 501B de parâmetros que sai sob Apache 2.0O modelo esparso de mixture-of-experts ativa 23B de parâmetros por token, lê até 1M de tokens e, pelos números da própria Reflection, compete com o GLM 5.2 em código e trabalho de agentes. Os pesos, o relatório técnico e as versões quantizadas saem ainda em outubro; por enquanto só existe um programa de acesso antecipado.
- NotíciasMeta lança o Muse Spark Open, um modelo aberto de 816B feito para rodar em dois Mac StudioO modelo de mistura de especialistas ativa 42B dos seus 816B parâmetros por token, lê texto, imagem, vídeo e áudio e tem contexto de 1M de tokens. A Meta o chama de modelo de pesos abertos mais capaz dos EUA, e a própria tabela dela confirma isso, mas ainda o coloca atrás do GLM 5.3 e do Kimi K3 na maioria dos benchmarks de agentes e código.
- NotíciasJev vs. Laya: pesos abertos entram na disputa da IA que decide em vez de conversarA ConvAI Innovations apresenta a Laya como alternativa aberta ao Jev, da TypeSafe AI. A comparação coloca hospedagem, calibração e condições dos benchmarks no centro da discussão.
Comentários
Dúvidas, correções ou sua própria visão são todas bem-vindas. Entre com o GitHub para participar.