DeepSeek
DeepSeek lança o V4.1-Flash-1017 com pesos sob licença MIT e abre as APIs pagas de Search e Fetch
A atualização menor leva o Terminal-Bench 4.0 da própria DeepSeek de 31,2 para 42,3, com janela de 1M de tokens, e as novas ferramentas de web custam US$ 0,75 por 1.000 chamadas bem-sucedidas, de graça nas ferramentas server-side até 31 de outubro.
Compartilhe esta notícia
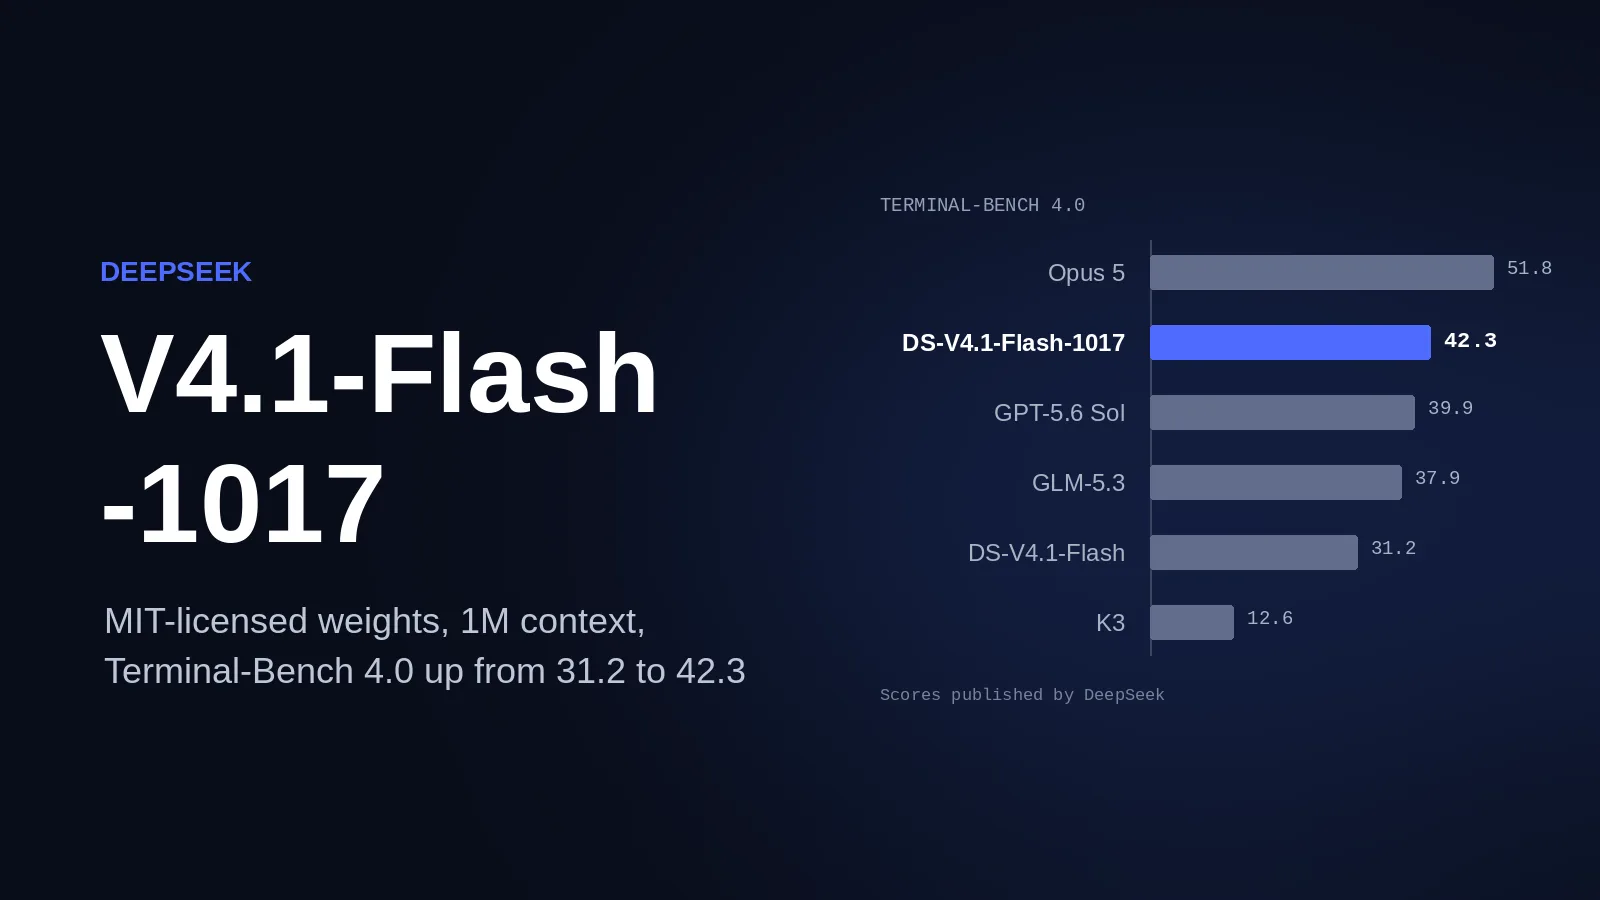
A DeepSeek lançou o DeepSeek-V4.1-Flash-1017, que o model card chama de "uma atualização menor do DeepSeek-V4.1-Flash" com "melhorias substanciais em raciocínio, código, tarefas agênticas e benchmarks visuais". Os pesos estão no Hugging Face sob a licença MIT, e o card recomenda janela de contexto de 1M de tokens e max_tokens de pelo menos 256K.
Junto com o modelo, a DeepSeek abriu suas APIs de Search e Fetch para todos. Cada uma custa US$ 0,75 por 1.000 requisições bem-sucedidas, e a cobrança por requisição nas chamadas server-side via DeepSeek Harness, Claude Code e Codex começa à 0h de Pequim de 1º de novembro (16h UTC de 31 de outubro).
O que mudou no modelo
A DeepSeek diz que a atualização também reduz o tempo de execução e o tamanho das respostas, então os agentes terminam mais rápido e gastam menos. Na tabela da própria empresa, o modelo vai de 74,2 para 77,0 no DeepSWE v1.1 (harness Mini-SWE-V2) e de 31,2 para 42,3 no Terminal-Bench 4.0 (harness do Claude Code). O Humanity's Last Exam sem ferramentas sobe de 36,8 para 42,6.
A mesma tabela o coloca à frente do GPT-5.6 Sol (73,0) e do Opus 5 (74,0) no DeepSWE, mas atrás do Opus 5 na maioria das outras linhas, incluindo o Terminal-Bench (51,8) e o Humanity's Last Exam (56,3). São pontuações publicadas pela DeepSeek, não testes independentes.
Rodando por conta própria
O lançamento não traz um chat template em Jinja. No lugar, uma pasta encoding tem uma implementação de referência em Python do formato de prompt, e a DeepSeek publicou o deepseek-recipe, um conjunto de bibliotecas em Rust com bindings para Python que converte requisições da Messages, da Chat Completions e da Responses API em prompts do DeepSeek V4 e V4.1. O card lista 763B de parâmetros e recomenda temperature 1,0 e top_p 1,0.
Pela API, o modelo é servido como deepseek-flash. Segundo a página de preços, os nomes antigos deepseek-v4-flash continuam funcionando, mas agora apontam para este modelo, cobrados pelo preço do Flash: US$ 0,15 por milhão de tokens de entrada em cache miss e US$ 0,60 por milhão de tokens de saída fora do pico, o dobro nos horários de pico.
As ferramentas de web
O Search recebe uma consulta e devolve resultados ranqueados; o Fetch recebe uma URL e devolve a página. Os dois usam a mesma chave de API da API de chat. Requisições com falha, resultados vazios e timeouts não são cobrados. O Startup Fortune relata um limite de 5 requisições por segundo por conta em cada endpoint, e lembra que a política de privacidade da DeepSeek guarda dados pessoais na China, o que importa se suas consultas são sensíveis.
O que conferir no seu stack
Se você já aponta um agente para deepseek-flash ou para os nomes antigos do Flash, já está neste modelo sem ter mudado nada, então rode seus próprios evals antes de confiar nos números novos. Se usa a busca server-side da DeepSeek pelo Claude Code ou pelo Codex, ela só é grátis até 31 de outubro; depois disso, reserve US$ 0,75 por 1.000 chamadas para cada um, Search e Fetch.
Fontes e leituras complementares
Compartilhe esta notícia
Conteúdos relacionados
- NotíciasReflection AI apresenta o Beam, um modelo de pesos abertos com 501B de parâmetros que sai sob Apache 2.0O modelo esparso de mixture-of-experts ativa 23B de parâmetros por token, lê até 1M de tokens e, pelos números da própria Reflection, compete com o GLM 5.2 em código e trabalho de agentes. Os pesos, o relatório técnico e as versões quantizadas saem ainda em outubro; por enquanto só existe um programa de acesso antecipado.
- NotíciasAnthropic lança o Claude Sonnet 5.5: código agêntico no nível do Opus pelo preço de um SonnetO segundo modelo da família 5.5 é mais de 30% mais rápido que o Sonnet 5, custa até 30% menos por tarefa, mantém os preços de US$ 2 e US$ 10 por milhão de tokens e passa o Opus 5.5 no Terminal-Bench.
- NotíciasMeta lança o Muse Spark Open, um modelo aberto de 816B feito para rodar em dois Mac StudioO modelo de mistura de especialistas ativa 42B dos seus 816B parâmetros por token, lê texto, imagem, vídeo e áudio e tem contexto de 1M de tokens. A Meta o chama de modelo de pesos abertos mais capaz dos EUA, e a própria tabela dela confirma isso, mas ainda o coloca atrás do GLM 5.3 e do Kimi K3 na maioria dos benchmarks de agentes e código.
Comentários
Dúvidas, correções ou sua própria visão são todas bem-vindas. Entre com o GitHub para participar.