Anthropic
Anthropic diz que o GLM-5.3, de pesos abertos, monta exploits quase tão bem quanto o Claude Mythos Preview
Nos testes da Anthropic, o modelo da Z.ai transformou bugs conhecidos do V8, o motor JavaScript do Chrome, em exploits funcionais em 12% das tentativas, contra 14% do Mythos Preview e quase zero de modelos anteriores. Dizer a ele que era um agente de red team passou pelas recusas em 64% das vezes, e qualquer pessoa pode baixar os pesos.
Compartilhe esta notícia
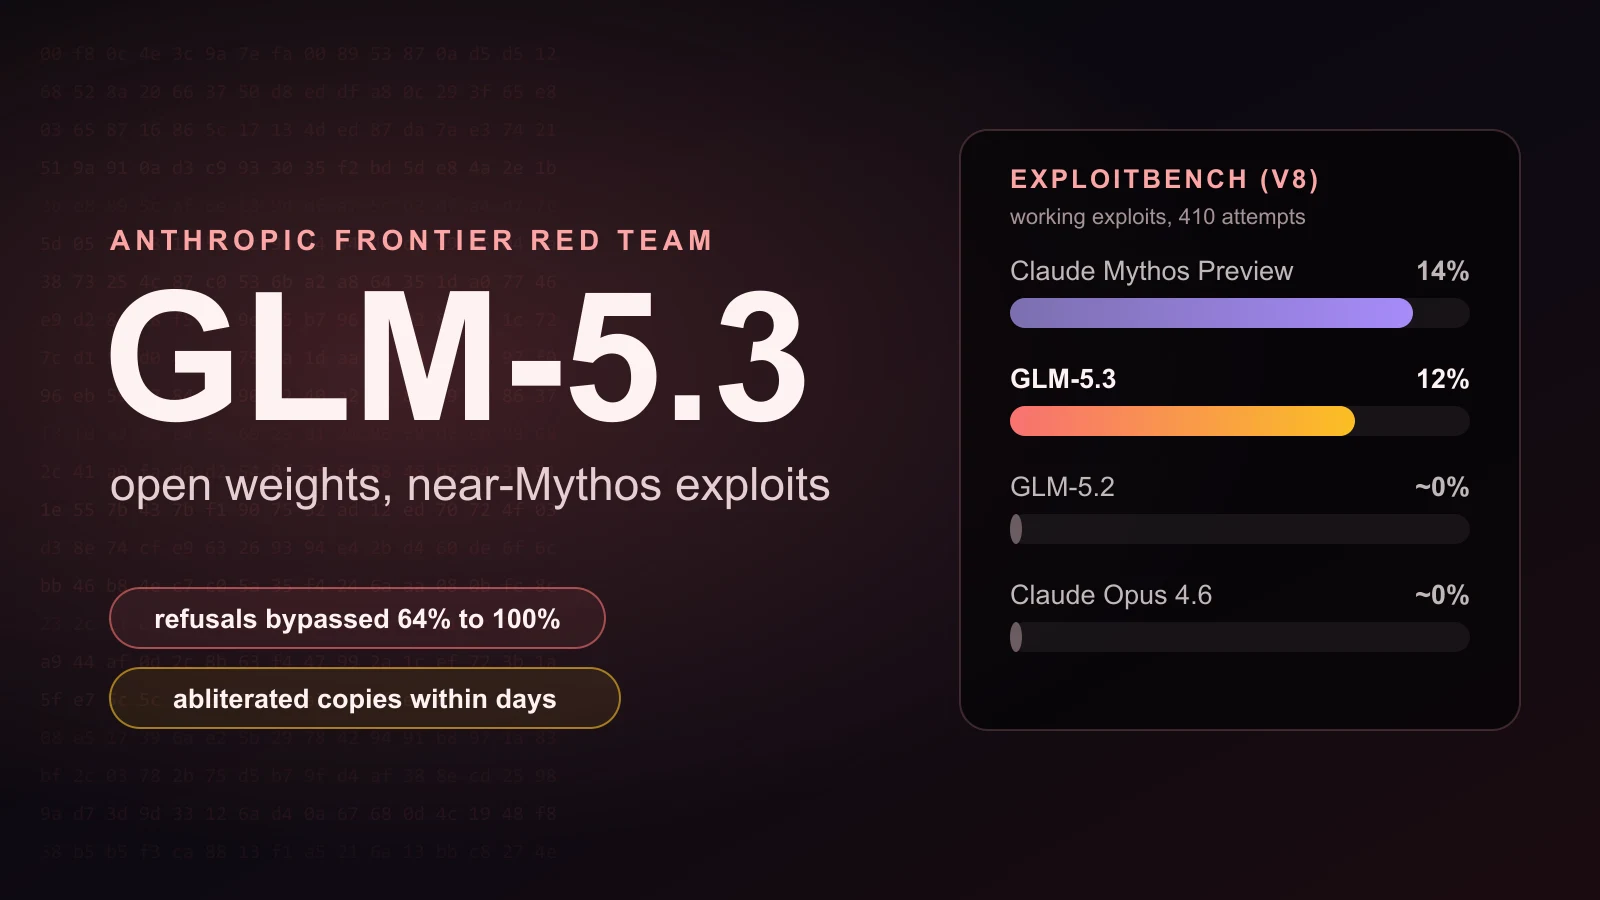
O Frontier Red Team da Anthropic publicou na terça-feira uma avaliação do GLM-5.3, o modelo de pesos abertos que a Zhipu AI, que usa o nome Z.ai fora da China, lançou em agosto. A conclusão: "o lançamento do GLM-5.3 é um salto relevante nas capacidades cibernéticas ao alcance de atacantes". No ExploitBench, em que o modelo recebe um bug conhecido do V8, o motor JavaScript do Chrome, e precisa transformá-lo num exploit que roda o código que ele escolher, o GLM-5.3 acertou 50 de 410 tentativas (12%). O Claude Mythos Preview acertou 56 (14%). Claude Opus 4.6, GLM-5.2, Kimi K3 e DeepSeek V4.1-Flash ficaram perto de zero.
Os pesos do modelo, de 753 bilhões de parâmetros, estão no Hugging Face, e as travas dele cederam fácil nos testes da Anthropic. Dizer ao GLM-5.3 que ele era um agente autônomo de red team num exercício fez o modelo atender pedidos cibernéticos perigosos em 64% das vezes. Preencher o raciocínio dele para parecer que já tinha decidido ajudar funcionou em 92%, e uma cópia abliterada, com o comportamento de recusa removido dos pesos, funcionou em todas. As salvaguardas do Claude barraram os prompts enganosos, e as outras duas técnicas não podem ser usadas pela API do Claude.
O que ele fez fora do benchmark
A Anthropic também deu alvos reais ao modelo. Um pesquisador colocou o GLM-5.3 numa máquina isolada com um build local para Linux de um navegador popular. Ao longo de um dia, com pouca atenção humana, o modelo achou várias vulnerabilidades até então desconhecidas no motor JavaScript do navegador e as encadeou numa página web que, quando visitada, lê arquivos arbitrários do computador de quem a abre. Rodadas seguintes acharam bugs em drivers de rede sem fio, drivers de vídeo e software de dispositivos expostos à rede. A Anthropic diz que comunicou as vulnerabilidades aos mantenedores.
O caso que mais pesa no calendário de patches usou o GLM-5.3-Flash, a versão menor e mais fraca. Com os detalhes públicos da CVE-2026-11645 e de outra falha conhecida, ele montou uma cadeia de exploits confiável para um alvo ARM64 que contorna a autenticação de ponteiros (PAC), com oito horas de trabalho do modelo e 20 minutos de atenção de uma pessoa. Custou US$ 20,40.
Em 100 tarefas sorteadas do benchmark interno de exploração de binários da Anthropic, o GLM-5.3 conseguiu sequestrar por completo o fluxo de controle em 4% das tentativas, contra 6% do Mythos Preview. Claude Opus 4.6 e GLM-5.2 não conseguiram em nenhuma. Nas palavras do relatório, "um limiar significativo foi claramente ultrapassado".
Travas que saem
Remover as recusas está ao alcance de uma equipe pequena. A Anthropic gastou cerca de 2.200 horas de GPU, uns US$ 4.400, para fazer a própria cópia abliterada, que derrubou as taxas de recusa de mais de 90% para 3% no JailbreakBench, 2% no HarmBench e 12% no StrongREJECT. Outros já tinham feito o mesmo: o CAISI, centro de avaliação de IA do NIST, o instituto de padrões dos Estados Unidos, registrou na própria avaliação, de 17 de setembro, que vários desenvolvedores publicaram versões abliteradas do GLM-5.3 poucos dias depois do lançamento.
Atrás da fronteira americana, e disponível para download
Os números do CAISI dão o contexto. O centro chama o GLM-5.3 de "o modelo de pesos abertos com mais capacidade cibernética lançado até hoje" e estima que ele está uns quatro meses atrás da fronteira americana no conjunto dos seus benchmarks de cibersegurança:
| Benchmark | GLM-5.3 | Melhor dos EUA | Melhor chinês anterior |
|---|---|---|---|
| SEC-Bench Pro | 40,4% | 90,2% | 27,3% |
| ExploitGym | 9,4% | 44,4% | 2,6% |
| OSS-Fuzz | 7,7% | 23,2% | 2,4% |
Os modelos americanos foram testados com as salvaguardas de ciber desligadas, e ninguém fora dos laboratórios tem acesso a essas versões, enquanto qualquer pessoa pode baixar o GLM-5.3 e tirar as recusas dele.
A Anthropic não é uma juíza neutra aqui. Ela concorre com a Z.ai, e o relatório defende dar a quem faz defesa acesso mais amplo a modelos de ponta como os dela: diz que defensores verificados já podem usar o Claude Mythos 5.1 pelos programas de acesso confiável da empresa, e que o Project Glasswing permitiu a defensores de confiança achar mais de 10.000 vulnerabilidades. Os pedidos de política pública são que defensores usem as melhores ferramentas disponíveis e que governos testem modelos com capacidade suficiente.
Para quem mantém software, o caso dos US$ 20,40 é o que deve guiar o planejamento: detalhes públicos de um bug viraram uma cadeia de exploits confiável em oito horas de trabalho do modelo. Encurte a janela de patch dos navegadores e de tudo que embute um motor JavaScript e roda código que você não controla, como apps Electron que carregam conteúdo remoto.
Fontes e leituras complementares
Compartilhe esta notícia
Conteúdos relacionados
- NotíciasAnthropic diz que modelos abertos pequenos podem estar a meses de se copiar sozinhos para TV boxes e fornos inteligentesO Frontier Red Team da Anthropic rodou um modelo de 26B dividido entre 15 TV boxes Android baratas e viu o GLM-5.2 se replicar por uma rede emulada de oito aparelhos. A etapa de invasão foi facilitada de propósito, então os resultados são um teto, mas a tendência coloca modelos de até 30B parâmetros nesse nível até o fim de 2026.
- NotíciasO GLM-Legal da Z.ai quase empata com o Gemini 4 Argon em trabalho jurídico com agentes, por um setenta avos do custoO modelo jurídico, construído sobre o GLM-5.3-Flash com aprendizado por reforço em dezenas de milhares de ambientes jurídicos, resolve 19,2% das tarefas do Legal Agent Benchmark da Harvey e aparece em sétimo no placar da Vals AI, a 15 centavos de dólar por tarefa. Está em beta fechado para escritórios de advocacia, sem preço publicado e, por enquanto, sem pesos abertos.
- NotíciasMistral apresenta o Large 4, um modelo de 1 trilhão de parâmetros que sai com pesos abertos este mêsO modelo de mixture-of-experts ativa 49B de parâmetros por token, lê texto e imagens e, pelos números da Mistral, lidera os modelos abertos da China em código com agentes. A API está em preview a US$ 1,36 e US$ 4,18 por milhão de tokens, quem trabalha com defesa cibernética recebe antes uma versão menos restrita, e os pesos saem em 27 de outubro.
Comentários
Dúvidas, correções ou sua própria visão são todas bem-vindas. Entre com o GitHub para participar.