laya-classifier: um filtro de segurança de e-mail em que o modelo lê e o código confere
Construí um filtro de phishing funcional com o Laya, o modelo de decisão de pesos abertos: cinco perguntas tipadas numa única passada, verificações determinísticas nos cabeçalhos e uma política que exige evidência antes da quarentena.
Compartilhe este post
Quando escrevi sobre o Jev e o Laya, a proposta era de modelos que decidem em vez de conversar: você entrega um texto e algumas perguntas tipadas, e eles devolvem valores que o seu código consegue usar, com probabilidades, numa única passada. Nada de prosa gerada para interpretar, nada para alucinar. Triar e-mails suspeitos era um dos casos de uso da lista, então construí um: o laya-classifier, um filtro de segurança de e-mail em cima dos pesos abertos do Laya, rodando na minha própria máquina.
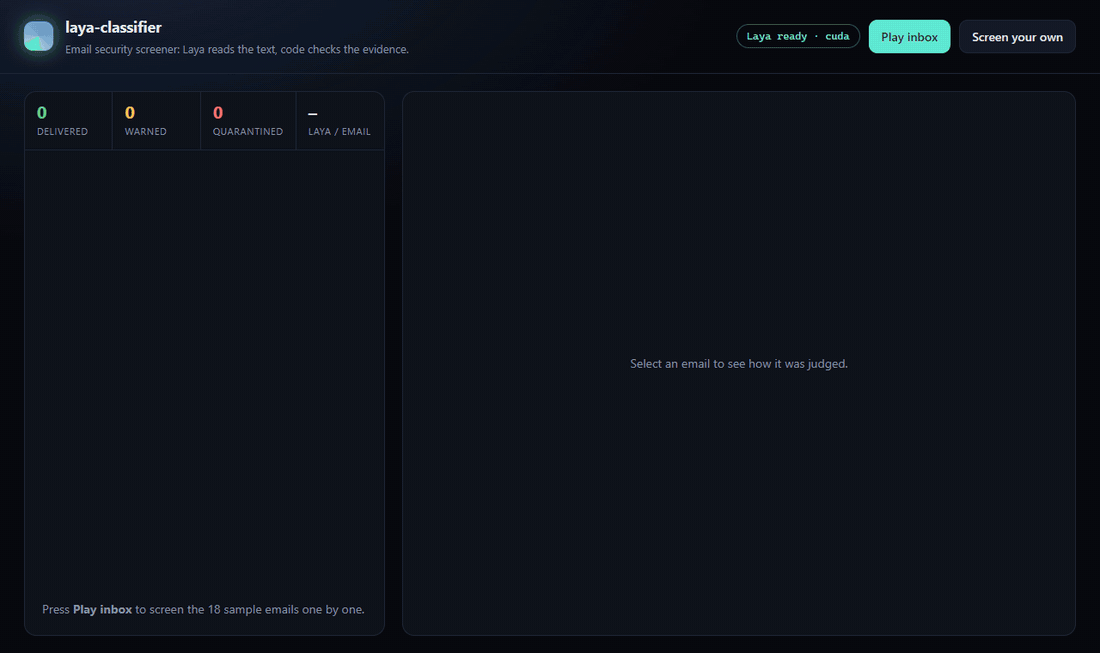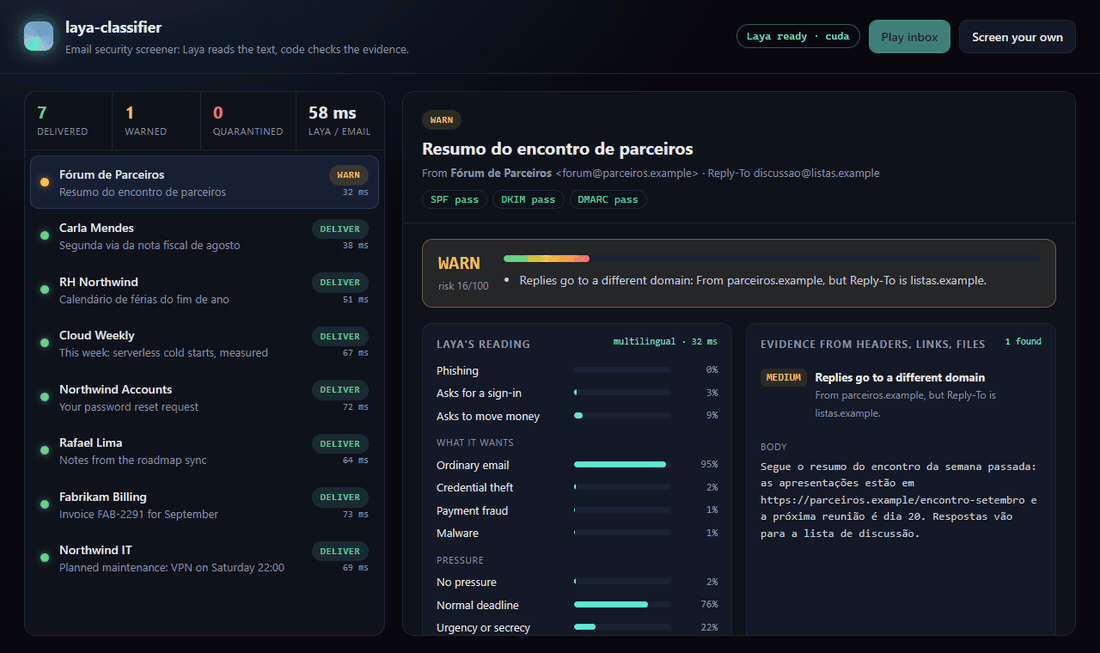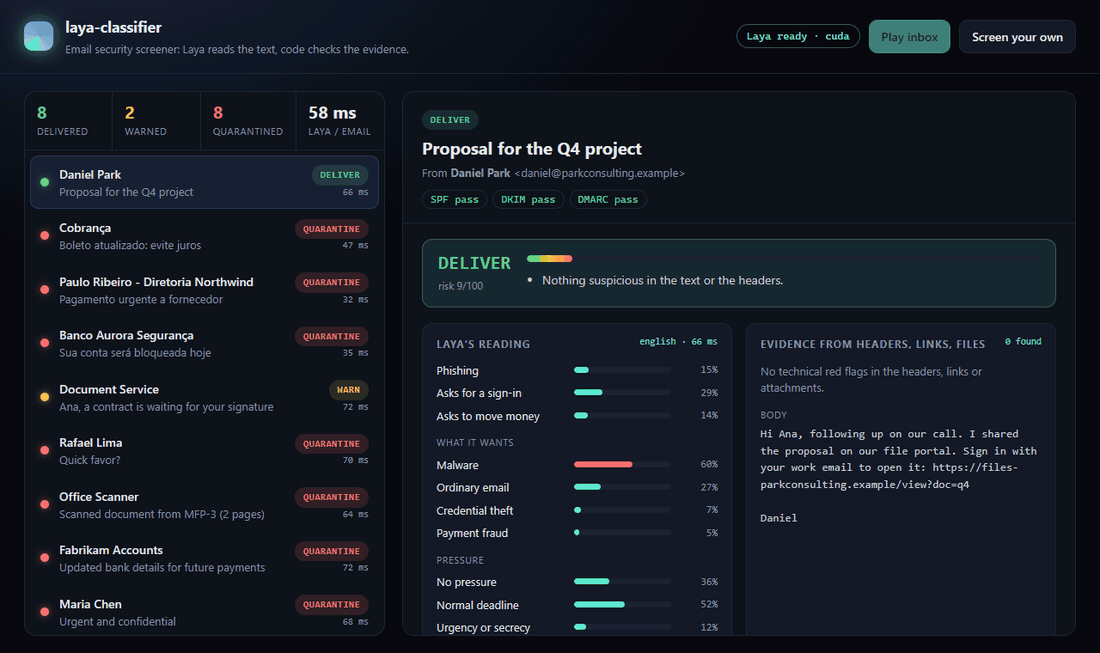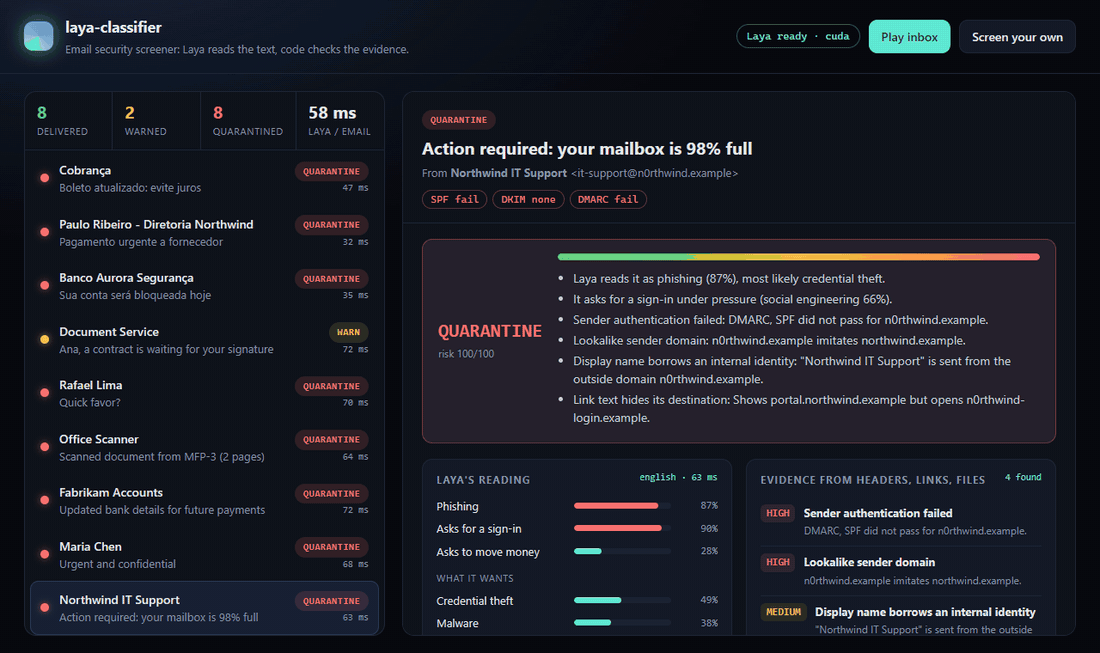
Ele recebe um e-mail bruto, decide entregar (deliver), alertar (warn) ou quarentena (quarantine) e explica o porquê. O painel e a API são um único app FastAPI; há também uma CLI, uma caixa de entrada de exemplo rotulada em inglês e português, um script de avaliação e testes que rodam sem baixar o modelo.
Dois leitores para cada e-mail
A decisão central foi nunca perguntar ao Laya algo que o código consegue conferir com exatidão. Se o DMARC passou, se o texto visível de um link aponta para outro lugar que não o href, se Scan_0928.pdf.exe é mesmo um PDF: isso são fatos. Um modelo lendo o corpo não enxerga nada disso, e um modelo chutando só acrescenta ruído. Então cada e-mail é separado uma vez e lido duas:
- O Laya lê o remetente, o assunto e o corpo e responde cinco perguntas sobre a intenção.
- O
signals.pylê os cabeçalhos, os links e os anexos: SPF, DKIM ou DMARC que falharam; remetente ou link num domínio parecido com um domínio protegido (n0rthwind.example,fabrikam-billing.example, punycode); texto de link que esconde o destino; Reply-To em outro domínio; nome de exibição que usa uma identidade interna; links encurtados ou com IP direto; anexos que podem executar código ou que se escondem atrás de uma extensão dupla.
Os dois leitores discordam com frequência, e é esse o objetivo. Um CEO pedindo uma transferência urgente e confidencial a partir de uma conta de e-mail gratuito autentica perfeitamente: SPF, DKIM e DMARC passam, porque o atacante é dono daquele domínio. Só o texto entrega o golpe. Já um aviso de caixa cheia vindo de n0rthwind.example pode parecer um e-mail comum da TI, mas falha no DMARC, e o link que mostra "portal.northwind.example" abre outro lugar.
Cinco perguntas em vez de uma
As primitivas do Laya são choice (escolher uma opção), score (um nível numa escala) e noul (a probabilidade de uma afirmação ser verdadeira). As cinco perguntas vão numa única chamada e voltam de uma única passada. Do questions.py:
QUESTIONS = {
    "phishing": {
        "type": "noul",
        "instructions": "Is the email in `body` a phishing or scam attempt to steal money, credentials or personal data?",
        "criteria": {"true": "phishing, scam or fraud", "false": "a legitimate email"},
    },
    "attack_type": {
        "type": "choice",
        "instructions": "What does the email in `body` try to get the reader to do?",
        "criteria": ATTACK_TYPES,  # credential_theft, payment_fraud, malware, ordinary
    },
    "pressure": {
        "type": "score",
        "instructions": "How much pressure does the email in `body` put on the reader to act?",
        "criteria": ["no pressure", "a normal deadline", "urgency, threats or a demand for secrecy"],
    },
    "asks_credentials": {"type": "noul", ...},
    "asks_payment": {"type": "noul", ...},
}
As perguntas seguem os limites que o próprio Laya documenta: todo noul tem critérios explícitos, e as chaves do choice são descritivas, nunca palavras como sim ou não. As três perguntas estreitas estão ali por um motivo medido. No checkpoint em inglês, sem ajuste fino, o amplo "isto é phishing?" é a leitura mais fraca: dá 3% para o e-mail de fraude do CEO. As perguntas estreitas leem o mesmo e-mail com clareza: 89% de que ele pede para mover dinheiro, 74% de que ele pressiona com urgência ou sigilo. Por isso o risco do Laya é o maior de duas leituras, a resposta ampla e uma pontuação de engenharia social, do policy.py:
@property
def social_engineering(self) -> float:
    return max(self.asks_credentials, self.asks_payment) * self.pressure_high

@property
def risk(self) -> float:
    return max(self.phishing, self.social_engineering)
Um e-mail que pede dinheiro ou um login e pressiona tem pontuação alta mesmo quando a pergunta ampla erra: o e-mail do CEO fica em 0,65. Um e-mail que pede dinheiro com calma, como uma fatura normal, continua baixo.
O idioma fica com o Router do Laya, que detecta a escrita e o idioma em menos de um milissegundo e manda cada e-mail para o checkpoint que o lê: e-mails em inglês para o laya (ModernBERT-large), em português para o laya-multilingual (mmBERT-base). O checkpoint multilíngue foi o leitor mais preciso da caixa de entrada: dá de 94% a 100% na pergunta ampla para os três ataques em português e 0% para todos os e-mails legítimos em português.
Evidência primeiro, depois a confiança
A política são quatro perguntas feitas em ordem, do policy.py:
if any(s.id in DECISIVE for s in high):
    return result("quarantine")
if high and (laya_risk >= t.laya_suspicious or len(high) >= 2):
    return result("quarantine")
if laya_risk >= t.laya_sure:
    return result("quarantine")
if high or laya_risk >= t.laya_suspicious or risk >= t.warn_risk:
    return result("warn")
if signals:
    return result("warn")
return result("deliver")
Um sinal decisivo (um link cujo texto mente sobre o destino, um anexo executável ou HTML) é hostil independentemente do texto. Outras evidências fortes, como um remetente com domínio parecido, só mandam para a quarentena quando o Laya tem pelo menos alguma suspeita (0,3), porque um domínio parecido sozinho pode ser um parceiro real e desajeitado. O Laya sozinho manda para a quarentena a partir de 0,5. Tudo que é suspeito abaixo disso recebe um alerta, e quem lê vê todos os motivos no resultado.
Uma exceção impede o filtro de barrar o e-mail que você mesmo pediu. Uma redefinição de senha que você solicitou pede mesmo que você faça login, e o Laya dá 0,40 para ela. Então um e-mail autenticado (DMARC aprovado) de um domínio protegido ou confiável, com todos os links em domínios conhecidos, conta o risco do Laya pela metade. Domínios parecidos nunca se qualificam, porque não são domínios conhecidos.
O que ele pega
Medi com o eval/evaluate.py nos 18 e-mails rotulados que acompanham o repositório: 10 ataques e 8 mensagens legítimas, 12 em inglês e 6 em português, todos fictícios e em domínios reservados .example. O script avalia três filtros na mesma caixa de entrada, para mostrar a contribuição de cada parte:
| Filtro | Ataques sinalizados | E-mails legítimos sinalizados |
|---|---|---|
| Só os sinais | 5/10 | 0/8 |
| Só o Laya | 6/10 | 0/8 |
| Combinado | 9/10 | 1/8, uma lista de e-mail com Reply-To diferente, rotulada alertar |
Nenhum dos leitores pega mais de seis ataques sozinho; juntos pegam nove, e nenhum e-mail legítimo vai para a quarentena. 16 dos 18 veredictos batem exatamente com os rótulos. O falso aviso de assinatura eletrônica recebe um alerta em vez de quarentena, e o ataque que passa é uma "proposta" num portal de arquivos, de um domínio que autentica e não imita ninguém: só o texto educado entrega o golpe. A tabela completa, e-mail por e-mail, está no repositório.
| Checkpoint | E-mails | Latência do Laya, RTX 5050 de notebook | Latência do Laya, CPU i7-14650HX |
|---|---|---|---|
laya (inglês) | 12 | 62 ms | 2,1 s |
laya-multilingual | 6 | 30 ms | 0,66 s |
São medianas para as cinco perguntas sobre um e-mail. Uma caixa de entrada de 18 e-mails é pequena, e os limites foram escolhidos nela. Os números mostram como os dois leitores se complementam, não como o filtro se sai com os seus e-mails: o próximo passo num uso real é rotular algumas centenas de e-mails da sua própria caixa e reajustar os limites, e o Laya traz um notebook de ajuste fino para quando só o modelo base não bastar.
Rodando
git clone https://github.com/gabe-santana/laya-classifier
cd laya-classifier
python -m venv .venv
.venv/bin/python -m pip install torch --index-url https://download.pytorch.org/whl/cu128   # só com GPU
.venv/bin/python -m pip install -e ".[dev]"
laya-screener serve                 # painel e API em http://127.0.0.1:8000
laya-screener screen samples/*.eml  # ou direto no terminal
A primeira execução baixa os checkpoints do Hugging Face. Aperte Play inbox para ver os exemplos sendo filtrados, ou Screen your own para colar um e-mail. A API aceita um .eml bruto ou campos simples:
curl -s localhost:8000/api/screen -H 'content-type: application/json' -d '{
  "from": "Maria Chen <[email protected]>",
  "subject": "Urgent and confidential",
  "body": "I need you to wire $48,200 before 3 pm today. Keep this between us."
}'
A resposta traz o veredicto, uma pontuação de risco de 0 a 100, os motivos, todos os sinais, as probabilidades do Laya e qual checkpoint leu o e-mail. O config/screener.json define quem o filtro protege: os seus domínios, os parceiros que os atacantes imitam e os executivos cujos nomes aparecem em nomes de exibição falsificados.
O que eu gosto nesse formato é que cada parte faz só aquilo em que é boa. O modelo lê a intenção em dois idiomas em dezenas de milissegundos, o código confere fatos que nunca mudam, e a política é uma dúzia de linhas legíveis que decidem quanta evidência uma quarentena exige. O modelo nunca precisa acertar sobre o DMARC, e o código nunca precisa entender um CEO com pressa.
Projeto open source
Explore o filtro, o painel, a caixa de entrada de exemplo e a avaliação no repositório.
Ver o código no GitHubCompartilhe este post
Conteúdos relacionados
- BlogAgenticMesh: arquitetura de IA que vai além do diagramaComo construí um MVP de RAG com FastAPI, Celery, Qdrant, Azure AI Foundry e streaming, e o que falta para produção.
- BlogGuia definitivo de redes no Azure: do CIDR ao hub e spokeTudo o que você precisa para projetar, proteger e diagnosticar redes no Azure, do planejamento de endereços à conectividade híbrida, private endpoints e hub e spoke.
- BlogRodando agentes Claude em background: execuções headless, agendamentos, routines e o Agent SDKTodas as formas de rodar um agente Claude sem ninguém olhando, do claude --bg ao Managed Agents, e um setup noturno testado com permissões, hooks, orçamento e um relatório confiável.
Comentários
Dúvidas, correções ou sua própria visão são todas bem-vindas. Entre com o GitHub para participar.