AgenticMesh: arquitetura de IA que vai além do diagrama
Como construí um MVP de RAG com FastAPI, Celery, Qdrant, Azure AI Foundry e streaming, e o que falta para produção.
Nesta página
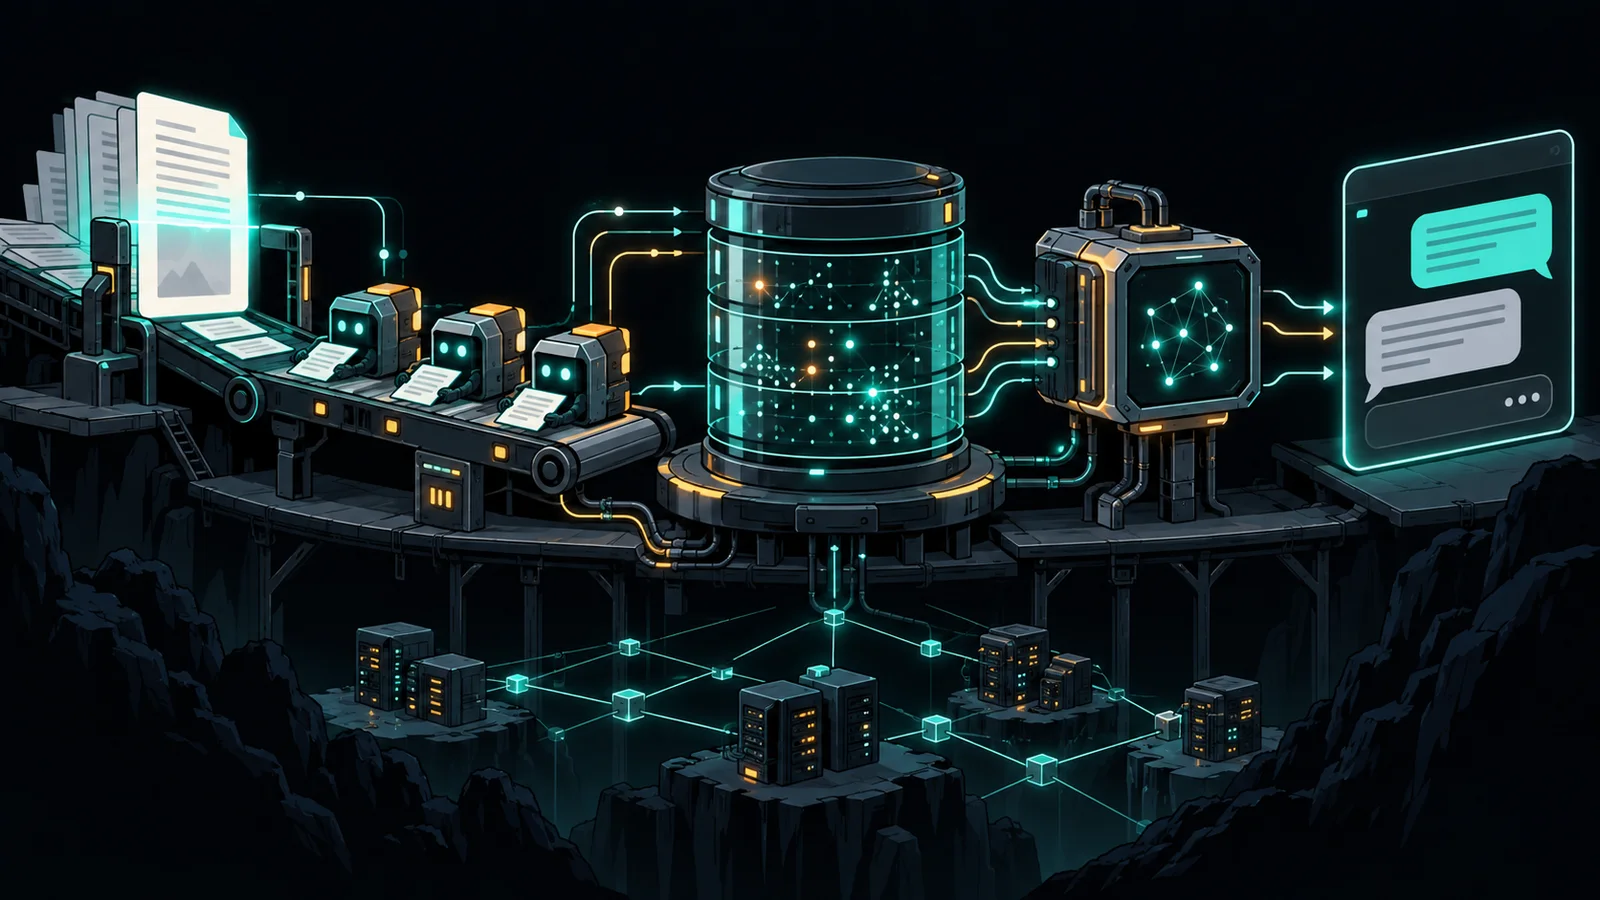
Um diagrama pode prometer qualquer coisa. O teste de uma arquitetura é mais inconveniente: subir os serviços, enviar um PDF, acompanhar seu processamento, fazer uma pergunta e descobrir se a resposta realmente veio do documento. Foi para fechar esse ciclo que construí o AgenticMesh.
É um projeto de arquitetura e implementação, não uma proposta de colocar um LLM no centro e torcer pelo melhor. Ele liga uma interface Next.js a uma API FastAPI, desacopla ingestão com Celery e Redis, persiste estado no PostgreSQL, indexa conteúdo no Qdrant e usa modelos de chat e embeddings via Azure AI Foundry. O resultado é um MVP executável de ponta a ponta. O compromisso desta análise é mostrar tanto as decisões que funcionam quanto as garantias que o protótipo ainda não oferece.
Veja o fluxo antes de ler o diagrama
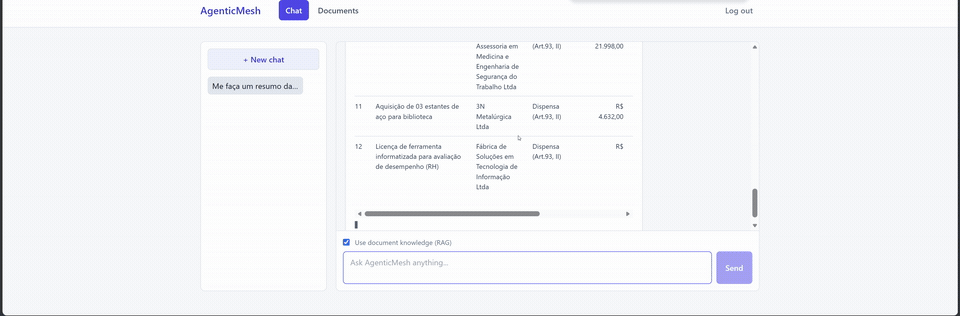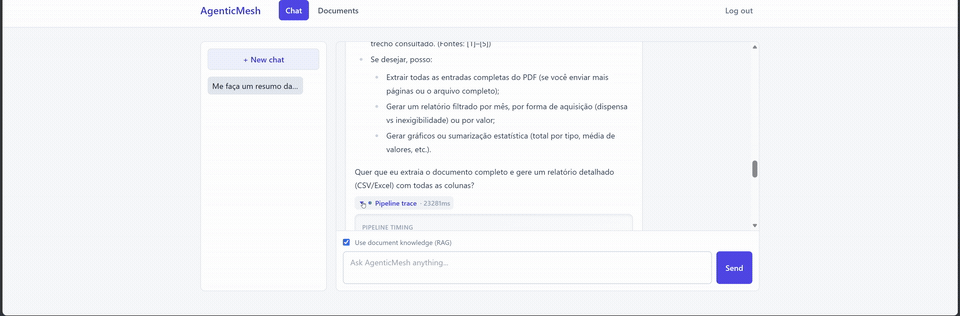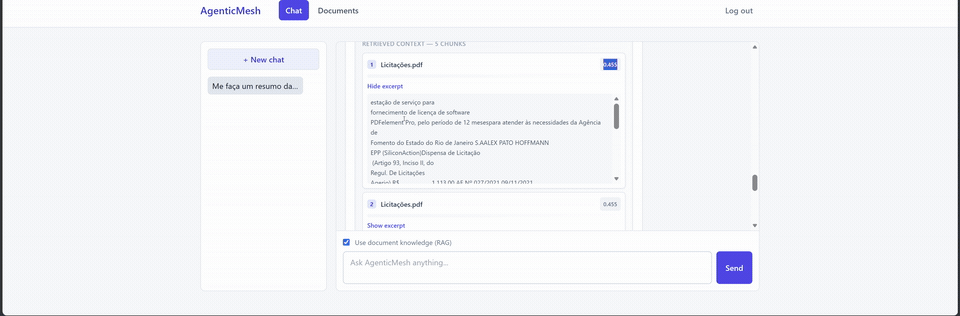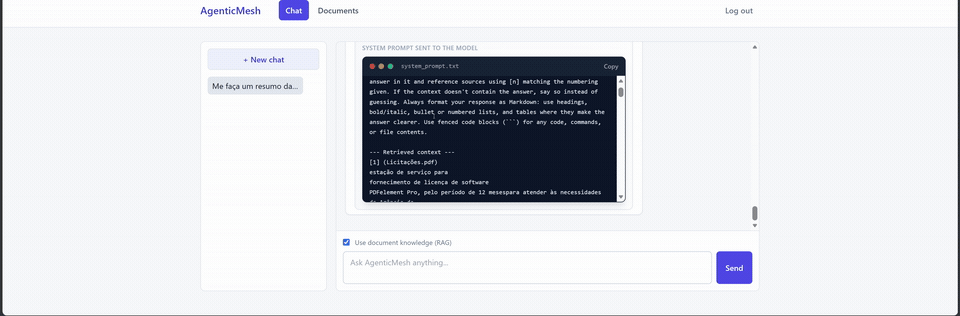
Demo do repositório original: upload, processamento, consulta e inspeção do pipeline. O GIF mostra o comportamento; o código abaixo mostra as escolhas.

A arquitetura em uma tela
Há dois caminhos com comportamentos diferentes. A ingestão é trabalho demorado e sai do ciclo de requisição: a API recebe o arquivo, registra o documento com status pending e enfileira a tarefa; o worker extrai texto, divide, gera embeddings, grava vetores e atualiza o status para ready ou failed. A consulta precisa responder de forma interativa: a API recupera trechos, monta contexto e transmite a saída do modelo ao navegador por Server-Sent Events (SSE). Isso evita que upload e geração disputem o mesmo tempo de resposta.
Os limites também são deliberados. PostgreSQL guarda estado transacional; Qdrant guarda representações para busca por similaridade. Redis é broker da fila, não a fonte de verdade dos documentos. A integração com os modelos fica em services/azure_ai.py, em vez de ser espalhada por rotas e componentes. A aplicação é separada em processos, mas não vou chamar cada processo de "microsserviço" só para enfeitar o desenho.
Ingestão: mensageria onde há trabalho de verdade
O endpoint de documentos aceita .txt, .md e .pdf, salva o arquivo em um volume compartilhado com o worker e enfileira uma tarefa Celery com o ID do documento. A tarefa faz o trabalho pesado. Este trecho é do worker real:
text = _extract_text(document.file_path)
chunks = chunk_text(text)
if not chunks:
    raise ValueError("No extractable text found in document")

vectors = azure_ai.embed_texts(chunks)
vector_store.ensure_collection()
vector_store.upsert_chunks(
    document.id, document.filename, document.category, chunks, vectors
)

document.status = "ready"
document.chunk_count = len(chunks)
O splitter tenta preservar parágrafos, linhas e frases antes de quebrar por palavra ou caractere, com sobreposição entre trechos. O Qdrant usa distância cosseno e IDs determinísticos derivados de documento e índice do chunk, úteis para reexecutar upserts sem multiplicar pontos. Ao excluir um documento, o projeto remove seus vetores e o arquivo, além da linha no banco.
Há uma sutileza que costuma aparecer só depois de uma falha intermitente: cada tarefa Celery executa seu próprio event loop com asyncio.run(). Reutilizar um engine assíncrono de banco criado para outro loop arrisca conexões presas a um loop encerrado. O worker cria e descarta um engine por execução. É um detalhe de implementação, mas é exatamente onde arquitetura encontra operação.
RAG não é uma palavra mágica: é uma cadeia verificável
Na pergunta, o sistema gera um embedding da consulta, busca até cinco trechos no Qdrant e os enumera como [1], [2] etc. A chamada síncrona de embeddings e a busca vetorial rodam em thread via anyio.to_thread.run_sync, para não bloquear o event loop da API. O contexto segue junto do histórico recente e da instrução do agente para o endpoint de chat do Azure AI Foundry.
O núcleo da orquestração é uma classe Python pequena. Este é o trecho que recupera, constrói o prompt e transmite a resposta:
if enable_rag:
    sources = await rag.retrieve(prompt)
    context = rag.build_context_block(sources)
    if context:
        system_content += (
            "\n\n--- Retrieved context ---\n" + context + "\n--- End context ---"
        )

turns = [ChatTurn("system", system_content), *history, ChatTurn("user", prompt)]
async for delta in stream_chat(turns):
    yield {"type": "token", "content": delta}
O system prompt pede que o modelo fundamente a resposta no contexto e cite os números correspondentes; se o contexto não contiver a resposta, pede que diga isso. É uma instrução útil, não uma prova de que toda afirmação foi fundamentada. Uma citação gerada pelo modelo precisa ser conferida contra o trecho recuperado. Por isso o painel mostra fontes e scores, em vez de exigir confiança cega no texto final.
Também é importante ser preciso com o termo agente. O projeto tem um RAGChatAgent e um AgentRegistry que permite selecionar implementações. Ainda não há planejamento autônomo, uso de ferramentas externas, grafo de execução ou múltiplos agentes cooperando. A escolha de começar com uma classe simples deixa claro onde uma orquestração mais sofisticada teria valor real, sem importar um framework antes de existir essa necessidade.
APIs, streaming e observabilidade fazem parte do produto
A interface não espera a resposta inteira. Ela chama POST /api/v1/agent/stream; a rota autentica o usuário, valida a sessão, carrega até 20 mensagens anteriores e devolve um EventSourceResponse. O agente emite eventos token durante a geração e um evento done com fontes, prompt e tempos de retrieval e geração. A API registra a mensagem e um AgentRun com latência, quantidade de trechos e status. Isso conecta a experiência do usuário ao diagnóstico técnico.
O adaptador de modelos usa o SDK openai apontado ao endpoint compatível do Azure AI Foundry: client.responses.create(..., stream=True) para chat e client.embeddings.create(...) para vetores. É integração real por API, não uma captura de tela de um playground. Na interface, o Pipeline Trace mostra tempos, trechos recuperados, scores e o prompt efetivamente montado.
Esse trace responde a perguntas que importam em engenharia: a busca trouxe o documento certo? O atraso veio da recuperação ou do modelo? O contexto tinha material suficiente para responder? E revela um limite: exibir ou persistir um prompt com conteúdo de documentos pode expor dados sensíveis. Em produção, acesso, mascaramento e retenção desse trace precisariam de política explícita.
O que já demonstra e o que eu exigiria antes de produção
O repositório sobe seis serviços com Docker Compose: frontend, API, worker, PostgreSQL, Redis e Qdrant. O provedor de modelos é o Azure AI Foundry. Isso demonstra experiência prática com integração cloud de IA, containers, mensageria, APIs e bancos distintos. Não demonstra implantação da aplicação em Azure, AWS ou GCP: não há Kubernetes, Terraform, pipeline de deploy ou SLOs. Também existem testes de backend, mas eles ainda não cobrem a jornada inteira com dependências reais.
Se este MVP virasse uma solução para clientes, estas seriam minhas primeiras decisões, em ordem de risco:
- Isolamento de dados antes de escalar. As rotas de sessões e documentos filtram por usuário, mas a busca atual no Qdrant não aplica filtro por
user_id/tenant. Em ambiente multiusuário, isso pode devolver trechos de outro usuário. Eu propagaria a identidade do documento até o payload vetorial, filtraria toda consulta no servidor e testaria vazamento cruzado antes de liberar a funcionalidade. - Limites claros para conteúdo não confiável. Documento recuperado é dado, não instrução. Eu adicionaria testes de prompt injection, validação de citações, política de acesso aos trechos e cuidados com o trace. O system prompt sozinho não resolve isso.
- Ingestão resiliente e segura. Limites de tamanho e conteúdo do upload, parsing em ambiente restrito, timeout, retry/backoff, tratamento de tarefas mortas e reconciliação entre status no PostgreSQL e vetores no Qdrant. O status
failedé um começo, não substitui uma operação recuperável. - Evolução de dados e deploy. Migrações versionadas no lugar de
create_all()no boot, segredos gerenciados, storage de arquivos adequado à cloud, health checks end-to-end, métricas e rastreamento distribuído. Docker Compose é ótimo para reproduzir localmente; não é a estratégia de produção. - Qualidade mensurável de IA. Um conjunto de perguntas com fontes esperadas, avaliação de recuperação e grounding, orçamento de tokens/custo, testes de regressão de prompts e observação de latência por etapa. Trocar um prompt e torcer não é engenharia.
É aqui que a visão arquitetural e o código precisam se encontrar. O diagrama ajuda a decidir onde colocar limites. A implementação revela onde esses limites ainda vazam. Uma POC honesta serve para reduzir incerteza e priorizar o próximo experimento, não para declarar vitória prematura.
Minha leitura do projeto
AgenticMesh mostra como eu trabalho: defino responsabilidades, construo o caminho completo, exponho o comportamento para inspeção e aponto as falhas que precisam ser resolvidas antes de pedir confiança. Há APIs, processamento distribuído, integração com LLM e embeddings, busca vetorial, prompt engineering, streaming e uma interface que permite verificar o resultado. Há também escolhas que eu mudaria ao sair de um MVP para uma plataforma compartilhada. Saber dizer as duas coisas é parte do trabalho de arquitetura.
Projeto em código aberto
Explore a implementação, os testes, o Docker Compose e a demo completa no repositório.
Ver código no GitHubConteúdos relacionados
- BlogImplantando uma API RAG no Azure Container Apps com Terraform, passo a passoImplante uma API RAG no Azure Container Apps com identidade gerenciada, Key Vault, escala e health checks.
- BlogProtegendo servidores MCP: autenticação, escopos e limites contra prompt injectionProteja ferramentas MCP contra prompt injection com autorização, validação e limites testados.
- BlogAvaliando RAG como engenheiro: crie um conjunto de testes de recuperação em PythonCrie um conjunto versionado de testes de RAG e valide retrieval e fidelidade no CI.
Comentários
Dúvidas, correções ou sua própria visão são todas bem-vindas. Entre com o GitHub para participar.